Integraties en data20:05
Waarom staat er 14.200 PLN op de API-factuur
We laten zien hoe u binnen een week in de gebruikslogbestanden de oorzaak van een piek in de API-factuur opspoort, harde limieten en waarschuwingen instelt en de kosten met 35–60 procent verlaagt zonder nieuwe tools.
Beluister de samenvatting van het artikel
Synthetische stem.Wij delen wat we zelf hebben getest bij implementaties: kosteloos en zonder de aanname dat uw situatie identiek is. Bij een handelsbedrijf van 70 medewerkers gebruikt de klantenservice sinds januari een assistent die e-mails samenvat en offertes opstelt. Op de factuur van de API-leverancier in maart staat 14.200 PLN netto in plaats van 2.100 PLN. De code is niet gewijzigd en er zijn geen nieuwe functies uitgerold. Deze piek ontstaat door drie factoren in het usage-dashboard: input-tokens groeien mee met de gespreksgeschiedenis, een vraag boven de limiet wordt herhaald door een lus en één API-sleutel bedient vijf teams zonder budget per project.
Op de API-factuur staat het totaal van meerdere componenten: input-tokens (de volledige verzonden geschiedenis), output-tokens (gegenereerde content), reasoning-tokens, tool calling, structured output en afbeeldingen of audio als het model deze verwerkt. Het mechanisme per gespreksronde is eenvoudig: kosten per ronde = som van de input-tokens van de volledige geschiedenis × input-tarief plus gegenereerde tokens × output-tarief. Daarom kost een gesprek over een document van 20 duizend tokens vrijwel niets, terwijl ditzelfde gesprek met toevoeging van de volledige thread 200 duizend tokens bevat en het budget opmaakt voordat het model de eerste zin formuleert. De officiële OpenAI-tarieven staan in de prijzen, en de werking van tokens staat beschreven in de documentatie.
Wat er deze week al mogelijk is
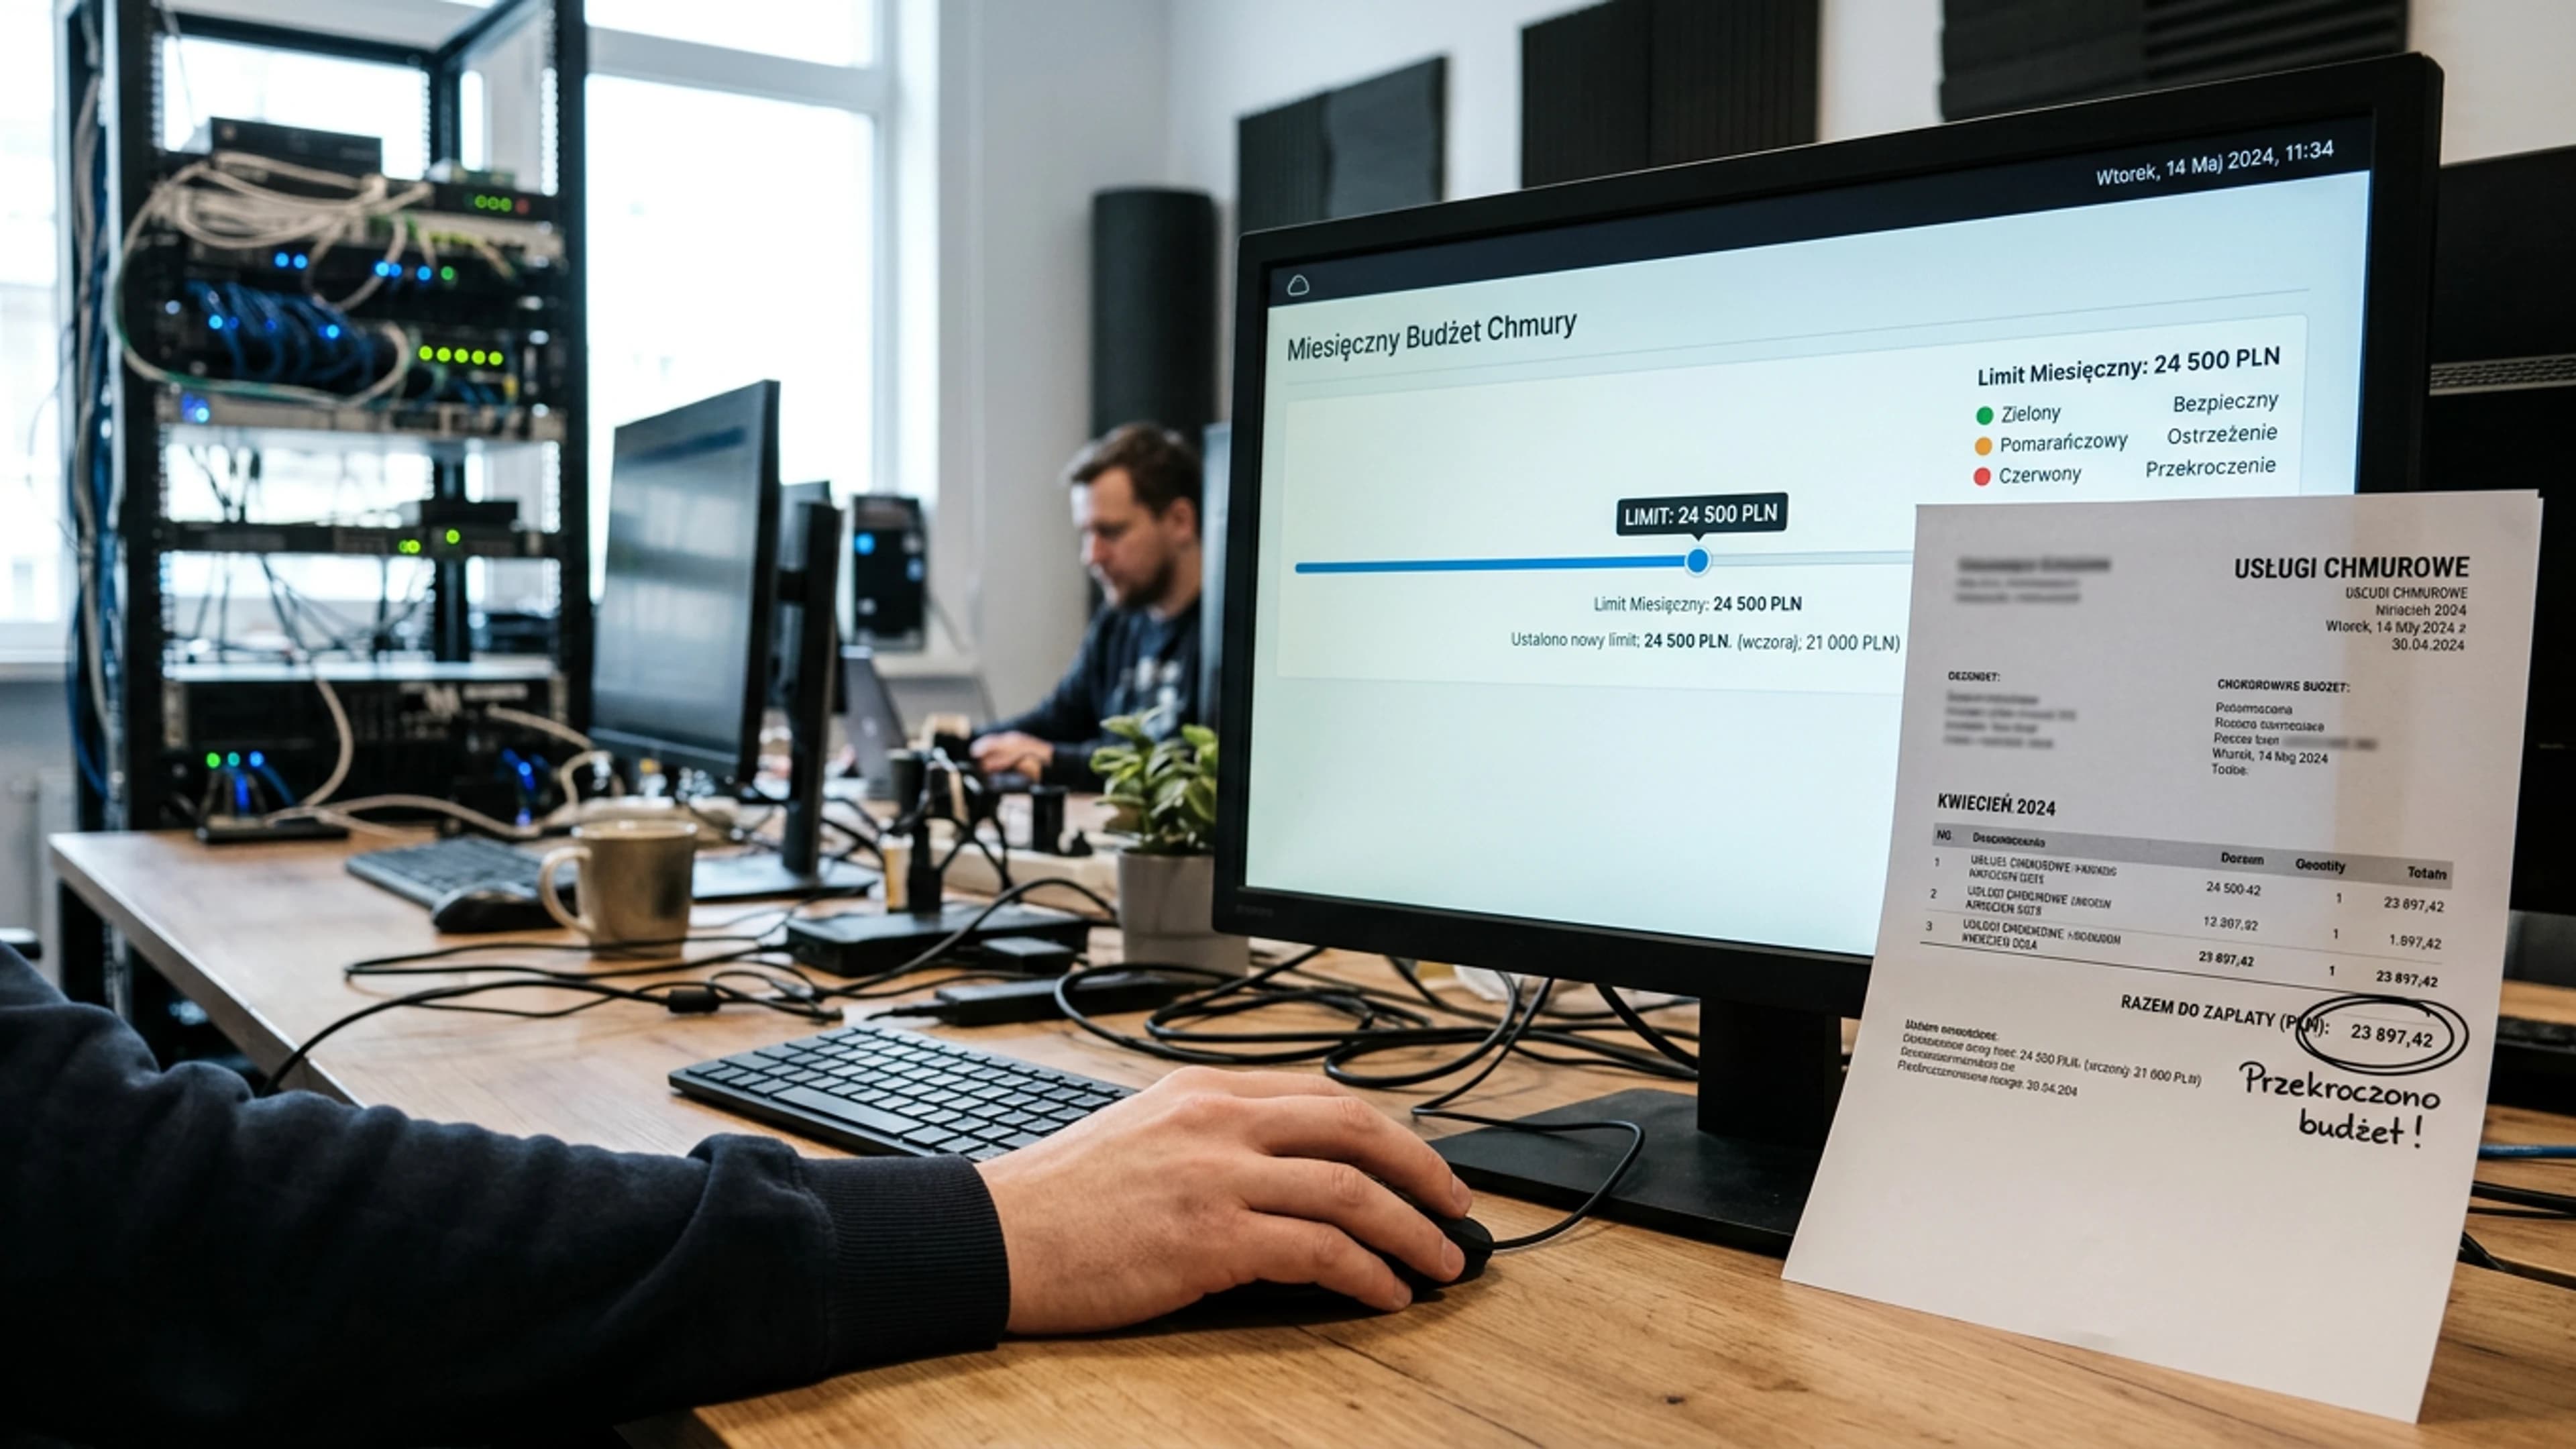
Stap 1: gebruiksrapport naar spreadsheet. Duur: 2 uur, uitgevoerd door API-beheerder of DevOps. Export uit provider-dashboard filteren op velden: model, api_key, project_id, cached_tokens, completion_tokens, requests. Samenvoegen in een draaitabel om te zien welk project en welke sleutel 80% van de factuur veroorzaakt. Stap 2: harde limiet en waarschuwingen in de console. Duur: 30 minuten, uitgevoerd door eigenaar van het facturatieaccount. Stel in OpenAI een monthly budget in, in Azure Cost Management een budget, in Google Cloud Billing een waarschuwing, in AWS Budgets een waarschuwing. Drempels: 50%, 80%, 100%. Bij 100% moet de API direct blokkeren. Stap 3: prompt caching bij herhaalde contexten. Duur: 2–4 uur, uitgevoerd door applicatie-engineer. Stuur niet dezelfde systeeminstructie opnieuw mee en stel cache-TTL in waar de documentatie dit toestaat. Geschatte besparing: 30–90% op input tokens. Stap 4: kleiner model voor routes met laag risico. Duur: 1 dag, uitgevoerd door productteam met developer. E-mails samenvatten, categorisatie en eerste offerteversies gaan naar GPT-4o mini, Claude Haiku of Gemini Flash, terwijl onderhandelingen en contractanalyses op het grotere model blijven. Tarieven voor Anthropic-modellen staan in de officiële prijslijst. Stap 5: aparte API-sleutels per team. Duur: 2 uur, uitgevoerd door IT Manager. Voor elk team een nieuwe sleutel en uitgavenlimiet. Daardoor verdwijnt een piek door een retry loop niet in de totale factuur.
Wat u niet direct moet doen
De eerste reflex is de aankoop van een platform voor AI-kostenbeheer of een LLM-gateway. De kosten van zo'n implementatie bedragen meestal 4.000–15.000 PLN en twee weken integratie, terwijl het acute probleem vaak neerkomt op één retry loop na een statuscode 429. De tweede fout is een algehele overstap naar het kleinste model. Bij taken in het Pools presteren GPT-4o mini, Claude Haiku en Gemini Flash goed bij categorisatie en samenvattingen, maar kunnen zij datums of bedragen in een offerte verdraaien. De derde fout is één harde limiet voor het hele bedrijf: op vrijdag om 16:40 blokkeert dit de productie in plaats van alleen een experiment. Stel limieten daarom in per sleutel, project en team. De vierde fout is migratie naar een andere provider of onderhandelen in de eerste week: zonder gebruiksrapport ontbreekt elke basis. De vijfde fout is het uitschakelen van Batch API en nachtelijke verwerking, waar het tarief soms 50% lager ligt en dit vaak het budget redt.
Hoe u na twee weken controleert of het werkt
Bereken na twee weken de kosten per 1 miljoen input- en output-tokens voor het project met voorheen de hoogste factuur. Deel in de spreadsheet het factuurbedrag door het totale aantal input- en output-tokens uit het veld usage. De referentiewaarde voor een kleiner model in het Pools bedraagt bij de wisselkoers van 24-04-2026 (1 USD = 3,78 PLN, bron NBP, nettobedragen) 0,70–0,90 PLN per 1 mln tokens input en output samen. Als de kosten voor de wijziging 2,40 PLN waren en na activering van cache en modelwissel daalden naar 1,10 PLN, bedraagt de besparing 54%. Drempel voor rollback: als de uitgave per 1 miljoen tokens niet onder 1,20 PLN zakt of het aandeel requests met 429 Too Many Requests boven de 5% blijft, zet het vorige model terug en controleer of de cache daadwerkelijk hits registreert.
Ontbreekt intern de tijd voor analyse en configuratie van limieten: HEXART voert dit uit als een kort traject van 3–5 werkdagen. We starten met een export van het gebruik per project en sleutel, waarna we budgetten, waarschuwingen en cachingregels inrichten. Na afronding ligt er een controlespreadsheet klaar voor wekelijks beheer. Details: https://hexart.pl/uslugi.
Bronmateriaal
Bronnen die we hebben geraadpleegd bij het schrijven. Bovenstaande tekst is van ons; deze websites zijn niet verantwoordelijk voor de inhoud en hebben deze niet geautoriseerd.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury
