Integraciones y datos20:05
Por qué su factura de API asciende a 14 200 PLN
Mostramos cómo identificar en una semana el origen del aumento de la factura de API en los registros de uso, definir límites estrictos y alertas, y reducir los gastos entre un 35% y un 60% sin herramientas nuevas.
Escuche el resumen del artículo
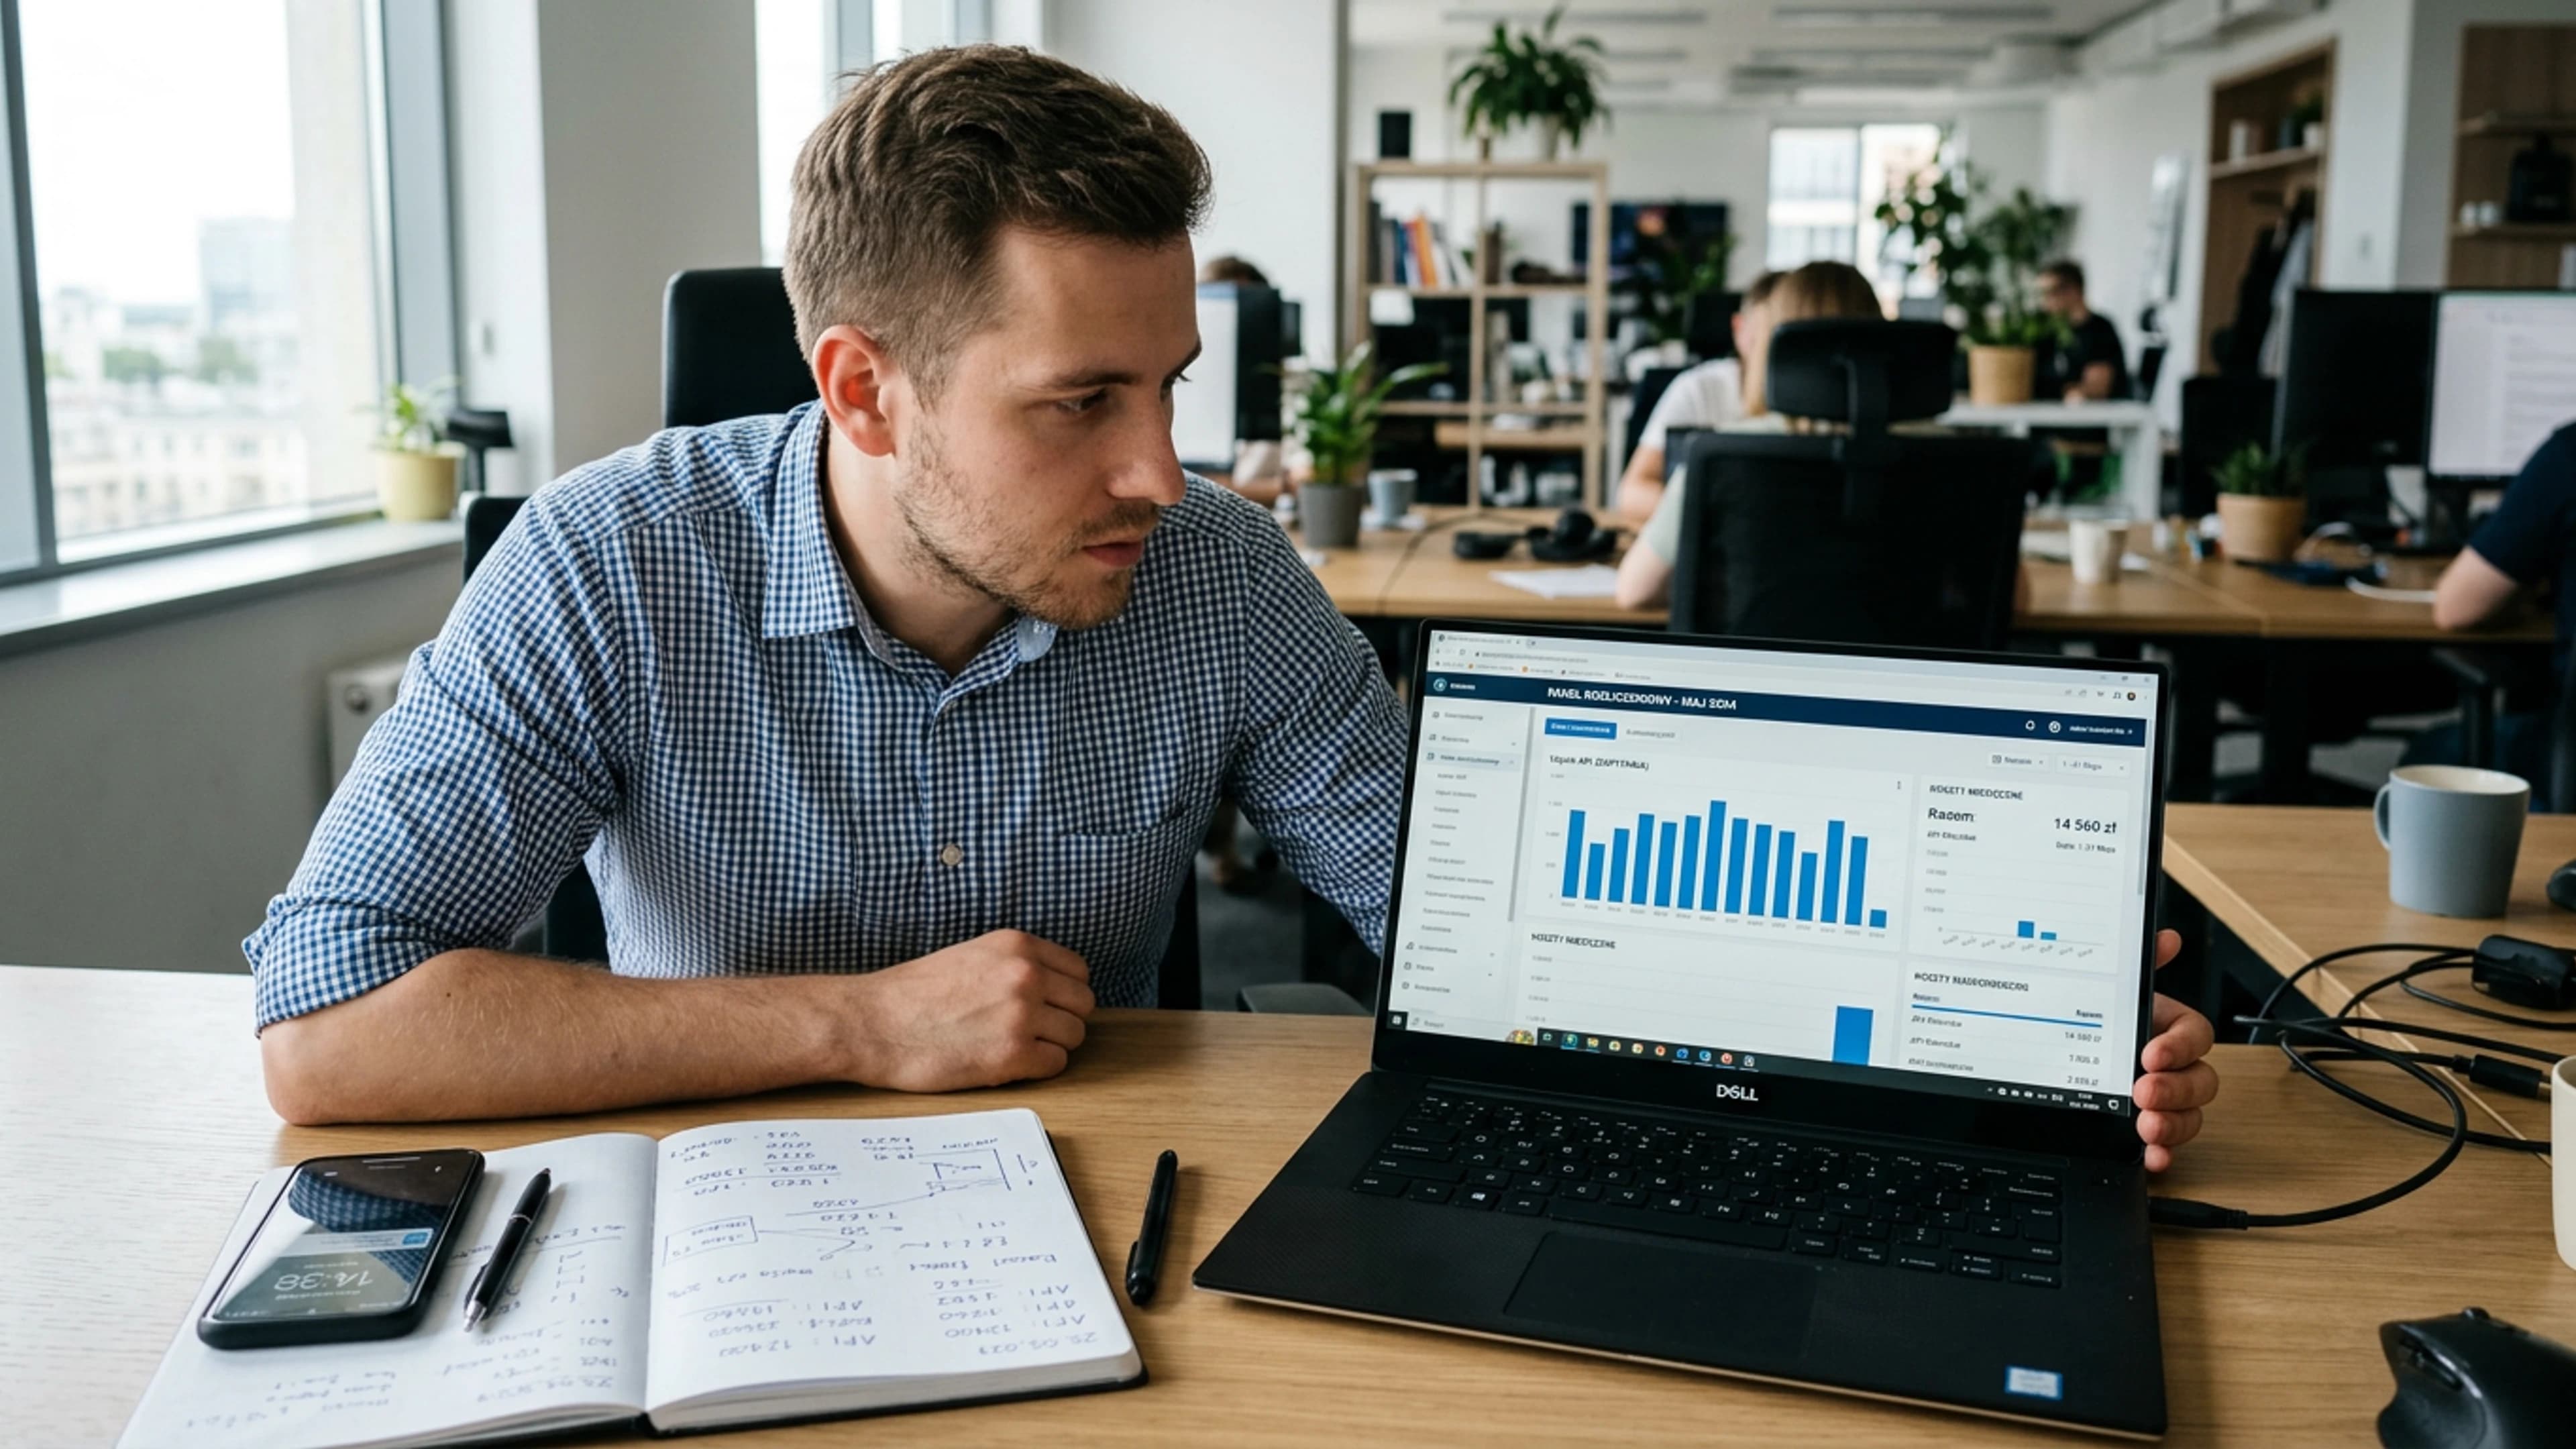
Voz sintética.Compartimos soluciones validadas en nuestras propias implementaciones: sin coste y adaptables a cada caso particular. En una empresa comercial de 70 empleados, el equipo de soporte utiliza desde enero un asistente para resumir correos y redactar ofertas. En marzo, la factura del proveedor de la API ascendió a 14 200 PLN netos frente a los 2 100 PLN habituales. El código permanecía inalterado y no se habían añadido funciones nuevas. Este incremento responde a tres factores visibles en el panel de consumo: acumulación de tokens de entrada con el historial de conversación, reintentos en bucle tras superar límites y uso compartido de una única clave API entre cinco equipos sin límites de gasto por proyecto.
La factura de una API refleja varios conceptos: tokens de entrada (todo el historial enviado), tokens de salida (contenido generado), tokens de razonamiento, llamadas a herramientas, salidas estructuradas e imágenes o audio si el modelo los procesa. La estructura de costes por interacción es directa: coste por turno = suma de tokens de entrada del historial completo × tarifa de entrada, más tokens generados × tarifa de salida. Por este motivo, consultar un documento de 20 000 tokens supone un coste mínimo, pero procesar esa misma consulta con todo el hilo acumulado alcanza los 200 000 tokens, agotando el presupuesto antes de generar la respuesta. Puede consultar los precios oficiales de OpenAI en sus tarifas y el cálculo de tokens en la documentación.
Qué implementar esta semana
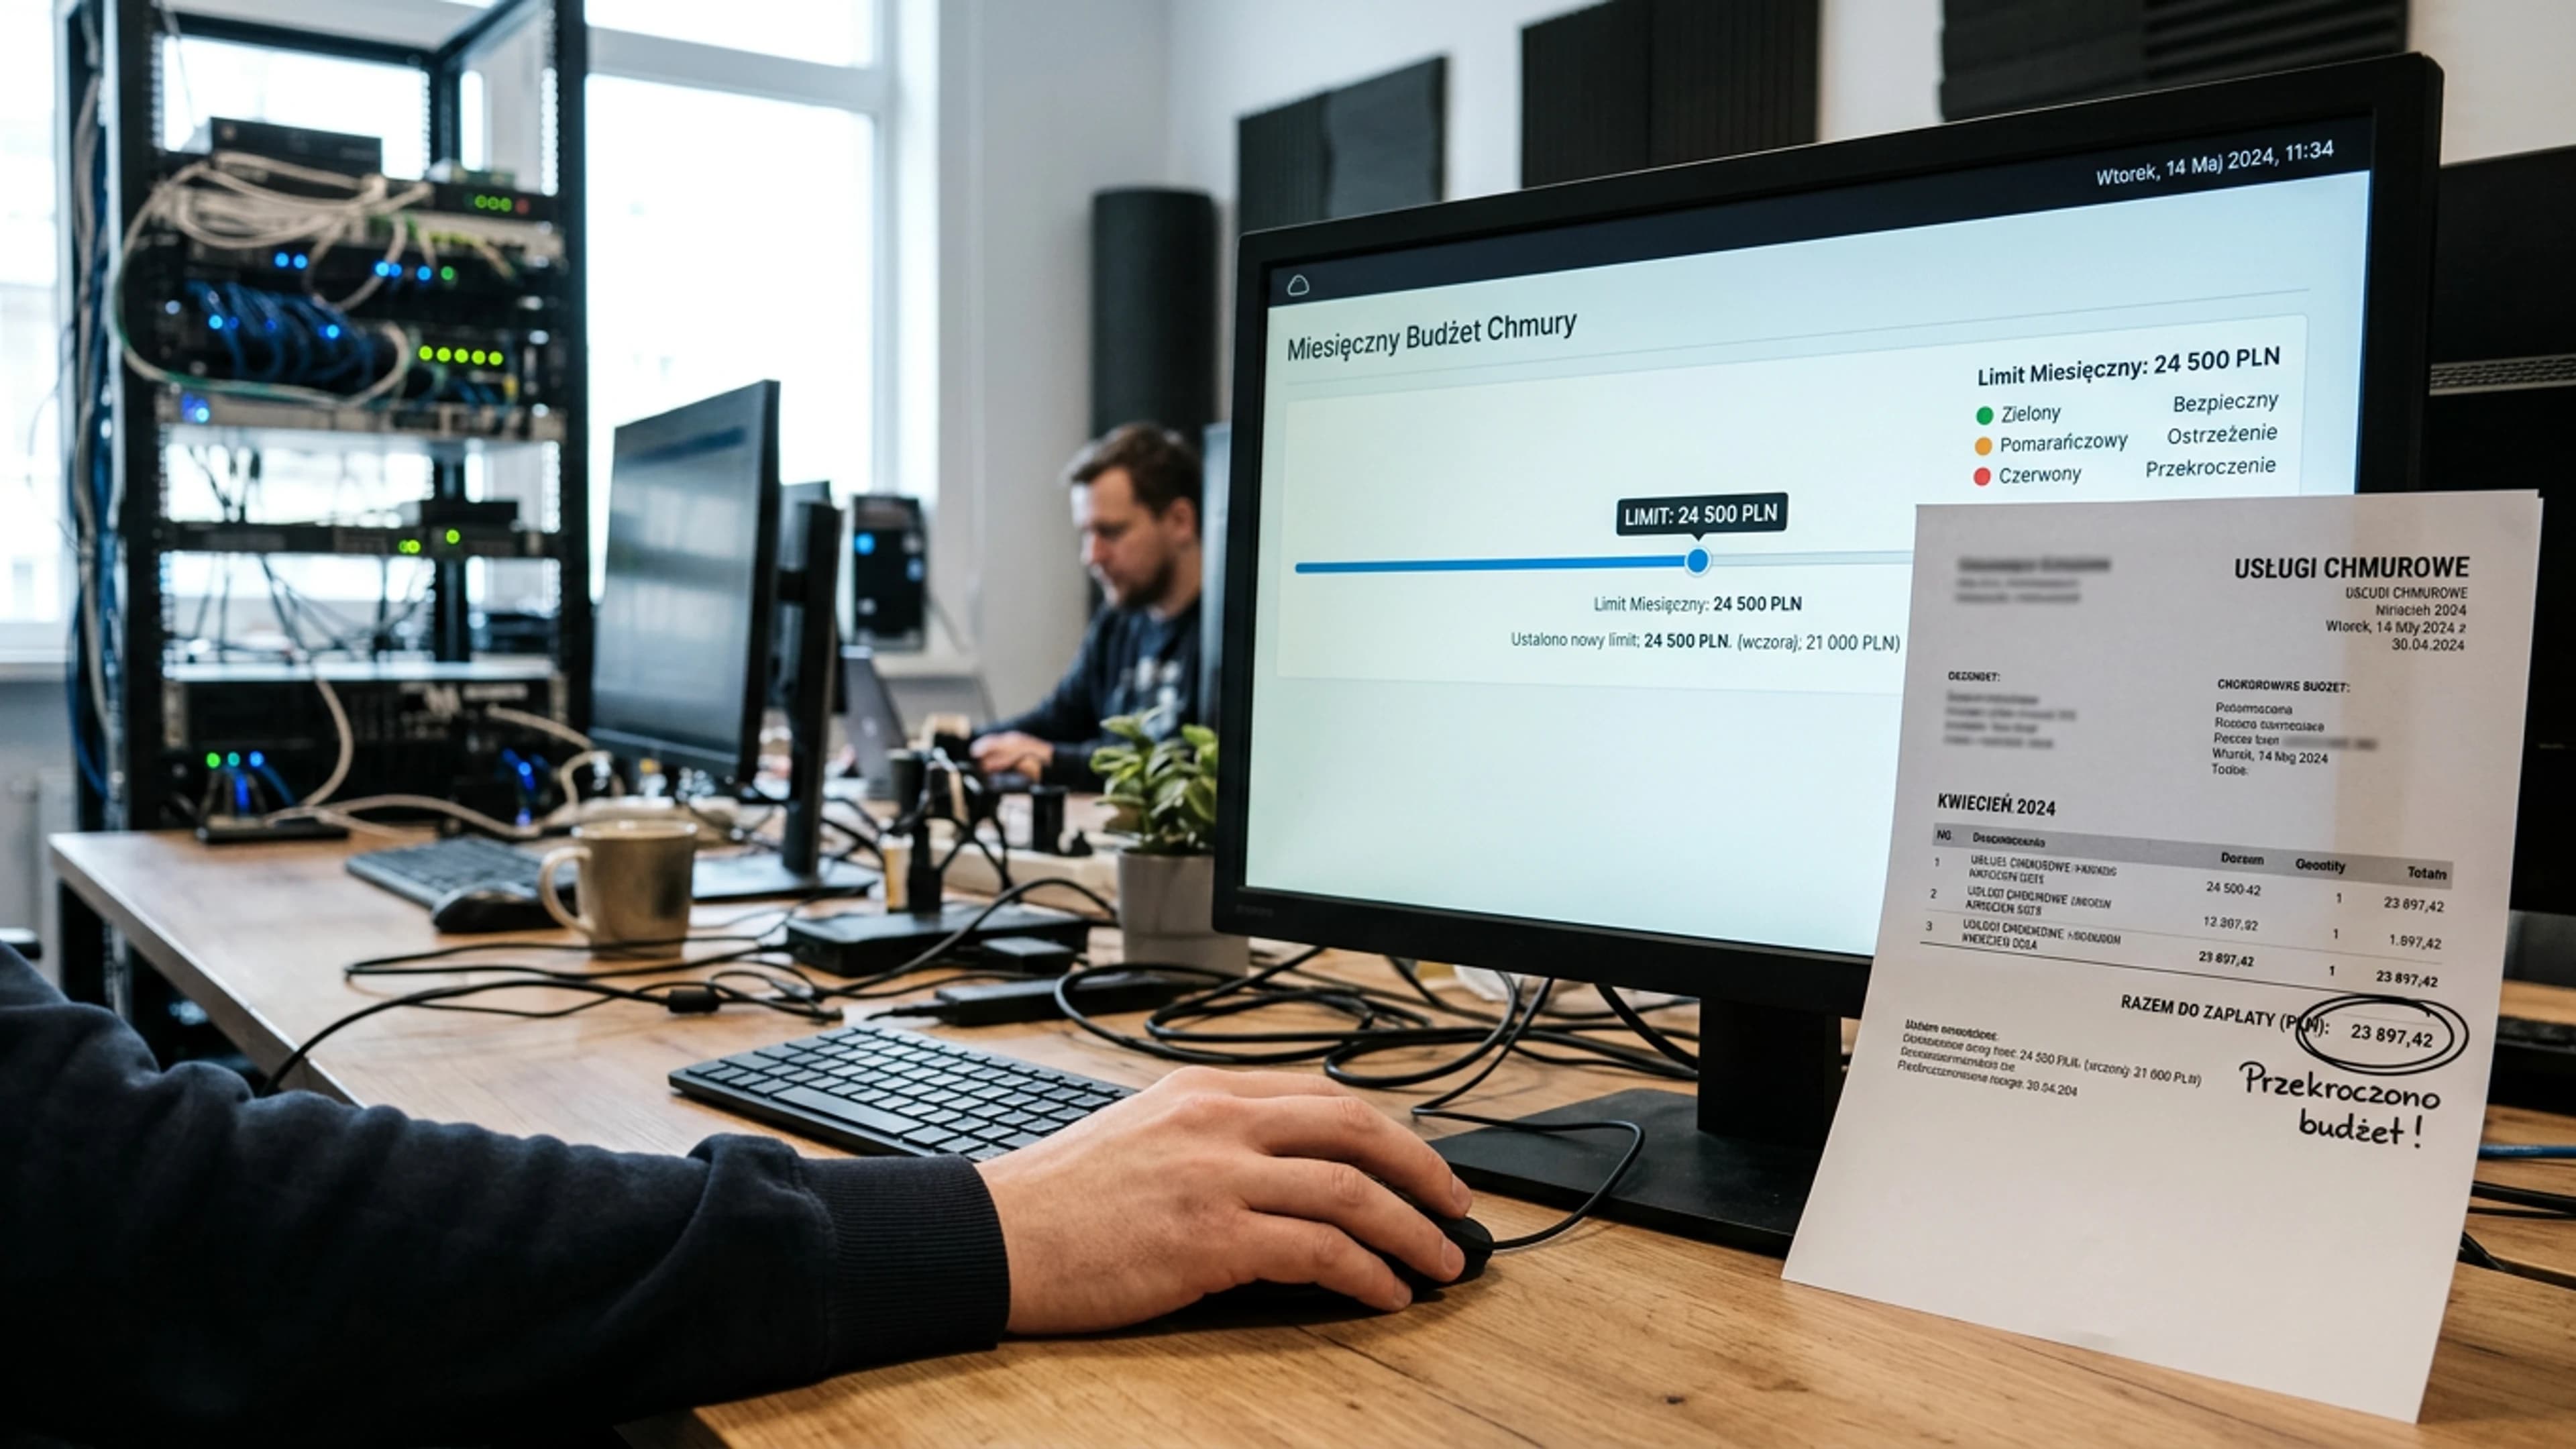
Paso 1: informe de consumo en hoja de cálculo. Duración: 2 horas. Responsable: administrador de API o DevOps. Exporte los datos desde el panel del proveedor y filtre por: model, api_key, project_id, cached_tokens, completion_tokens, requests. Cree una tabla dinámica para identificar qué proyecto y clave generan el 80% de la factura. Paso 2: límite estricto y alertas en consola. Duración: 30 minutos. Responsable: titular de la cuenta de facturación. Configure un monthly budget en OpenAI, un presupuesto en Azure Cost Management, una alerta en Google Cloud Billing y una alerta en AWS Budgets. Umbrales: 50%, 80%, 100%. Al alcanzar el 100%, la API debe detenerse por completo. Paso 3: almacenamiento en caché de prompts para contextos repetitivos. Duración: 2–4 horas. Responsable: ingeniero de aplicaciones. Evite enviar la misma instrucción de sistema repetidamente y defina el TTL de caché según la documentación técnica. Ahorro estimado: 30–90% del gasto en tokens de entrada. Paso 4: modelo más pequeño para flujos de bajo riesgo. Duración: 1 día. Responsable: equipo de producto con un desarrollador. Asigne resúmenes de correos, categorización y primeros borradores de propuestas a GPT-4o mini, Claude Haiku o Gemini Flash; reserve el modelo más grande para negociaciones y análisis contractual. Consulte las tarifas de Anthropic en su lista de precios oficial. Paso 5: claves de API independientes por equipo. Duración: 2 horas. Responsable: IT Manager. Genere una clave nueva y un límite de gasto por cada equipo. De este modo, un bucle de reintentos aislado no quedará oculto en la factura global.
Qué posponer para fases posteriores
El primer impulso suele ser contratar una plataforma de monitorización de costes de IA o una pasarela LLM. Esta implementación supone habitualmente un coste de 4 000–15 000 PLN y dos semanas de integración, cuando el problema inmediato suele reducirse a un bucle de reintentos tras un código 429. El segundo error consiste en migrar globalmente al modelo más pequeño. Para tareas en polaco, GPT-4o mini, Claude Haiku y Gemini Flash resuelven bien la categorización y los resúmenes, pero pueden alterar fechas o importes en presupuestos. El tercer error es fijar un único límite estricto para toda la empresa: un viernes a las 16:40 detendrá la producción y no solo las pruebas. En su lugar, establezca límites por clave, proyecto y equipo. El cuarto error es cambiar de proveedor o negociar tarifas durante la primera semana; sin un informe detallado de consumo no hay base para negociar. El quinto error es desactivar la Batch API y el procesamiento nocturno, donde las tarifas llegan a ser un 50% inferiores y a menudo constituyen la única vía para sostener el presupuesto.
Cómo verificar los resultados tras dos semanas
Tras dos semanas, calcule el coste por cada millón de tokens de entrada y salida en el proyecto que generaba la mayor factura. En la hoja de cálculo, divida el importe entre la suma de tokens de entrada y salida indicada en el campo usage. Como referencia para un modelo más pequeño en polaco, según el tipo de cambio del 24.04.2026 (1 USD = 3,78 PLN, fuente: NBP, importes netos), el coste se sitúa en 0,70–0,90 PLN por millón de tokens combinados de entrada y salida. Si antes del cambio el coste era de 2,40 PLN y tras activar la caché y sustituir el modelo desciende a 1,10 PLN, el ahorro alcanza el 54%. Criterio de reversión: si el coste por millón de tokens no baja de 1,20 PLN o el porcentaje de peticiones con 429 Too Many Requests sigue superando el 5% del total, restablezca el modelo anterior y verifique si la caché registra aciertos reales.
Si no dispone de tiempo para elaborar el informe y configurar los límites, HEXART interviene de forma directa: 3–5 días laborables. Comenzamos extrayendo el consumo por proyecto y clave, para después definir presupuestos, alertas y reglas de caché. Entregamos una hoja de control operativa para el lunes. Más información: https://hexart.pl/uslugi.
Fuentes
Materiales consultados durante la redacción. El texto anterior es nuestro; estas fuentes no se responsabilizan de su contenido ni lo han autorizado.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury
