Інтеграції та дані20:05
Звідки беруться 14 200 PLN у рахунку за API
Показуємо, як за тиждень знайти в логах usage джерело різкого зростання рахунку за API, налаштувати жорсткі ліміти та сповіщення й знизити витрати на 35–60 відсотків без нових інструментів.
Слухати стислий зміст статті
Синтетичний голос.Ділимося перевіреним на власних впровадженнях: безкоштовно та без припущення, що ваша ситуація є абсолютно ідентичною. У торговельній компанії на 70 осіб команда підтримки із січня використовує асистента, який створює саммарі листів і готує пропозиції. У березневому рахунку від постачальника API зазначено 14 200 PLN нетто замість 2 100 PLN. Код не змінювали, нових функцій не впроваджували. Цей стрибок спричинений трьома параметрами на панелі usage: вхідні токени зростають разом з історією діалогу, один запит після перевищення ліміту повторюється циклом, а один ключ API використовують п'ять команд без бюджетів на проєкт.
Рахунок за API складається з кількох позицій: вхідні токени (уся надіслана історія), вихідні токени (згенерований контент), reasoning tokens, tool calling, structured output, а також зображення чи аудіо, якщо модель їх обробляє. Механіка одного кроку розмови проста: вартість кроку = сума вхідних токенів з усієї історії × тариф in плюс згенеровані токени × тариф out. Тому розмова з документом на 20 тис. токенів коштує копійки, а та сама розмова після додавання всієї гілки містить 200 тис. токенів і вичерпує бюджет ще до першого речення моделі. Офіційні тарифи OpenAI містяться у прайс-листі, а підрахунок токенів описано в документації.
Що можна зробити цього тижня
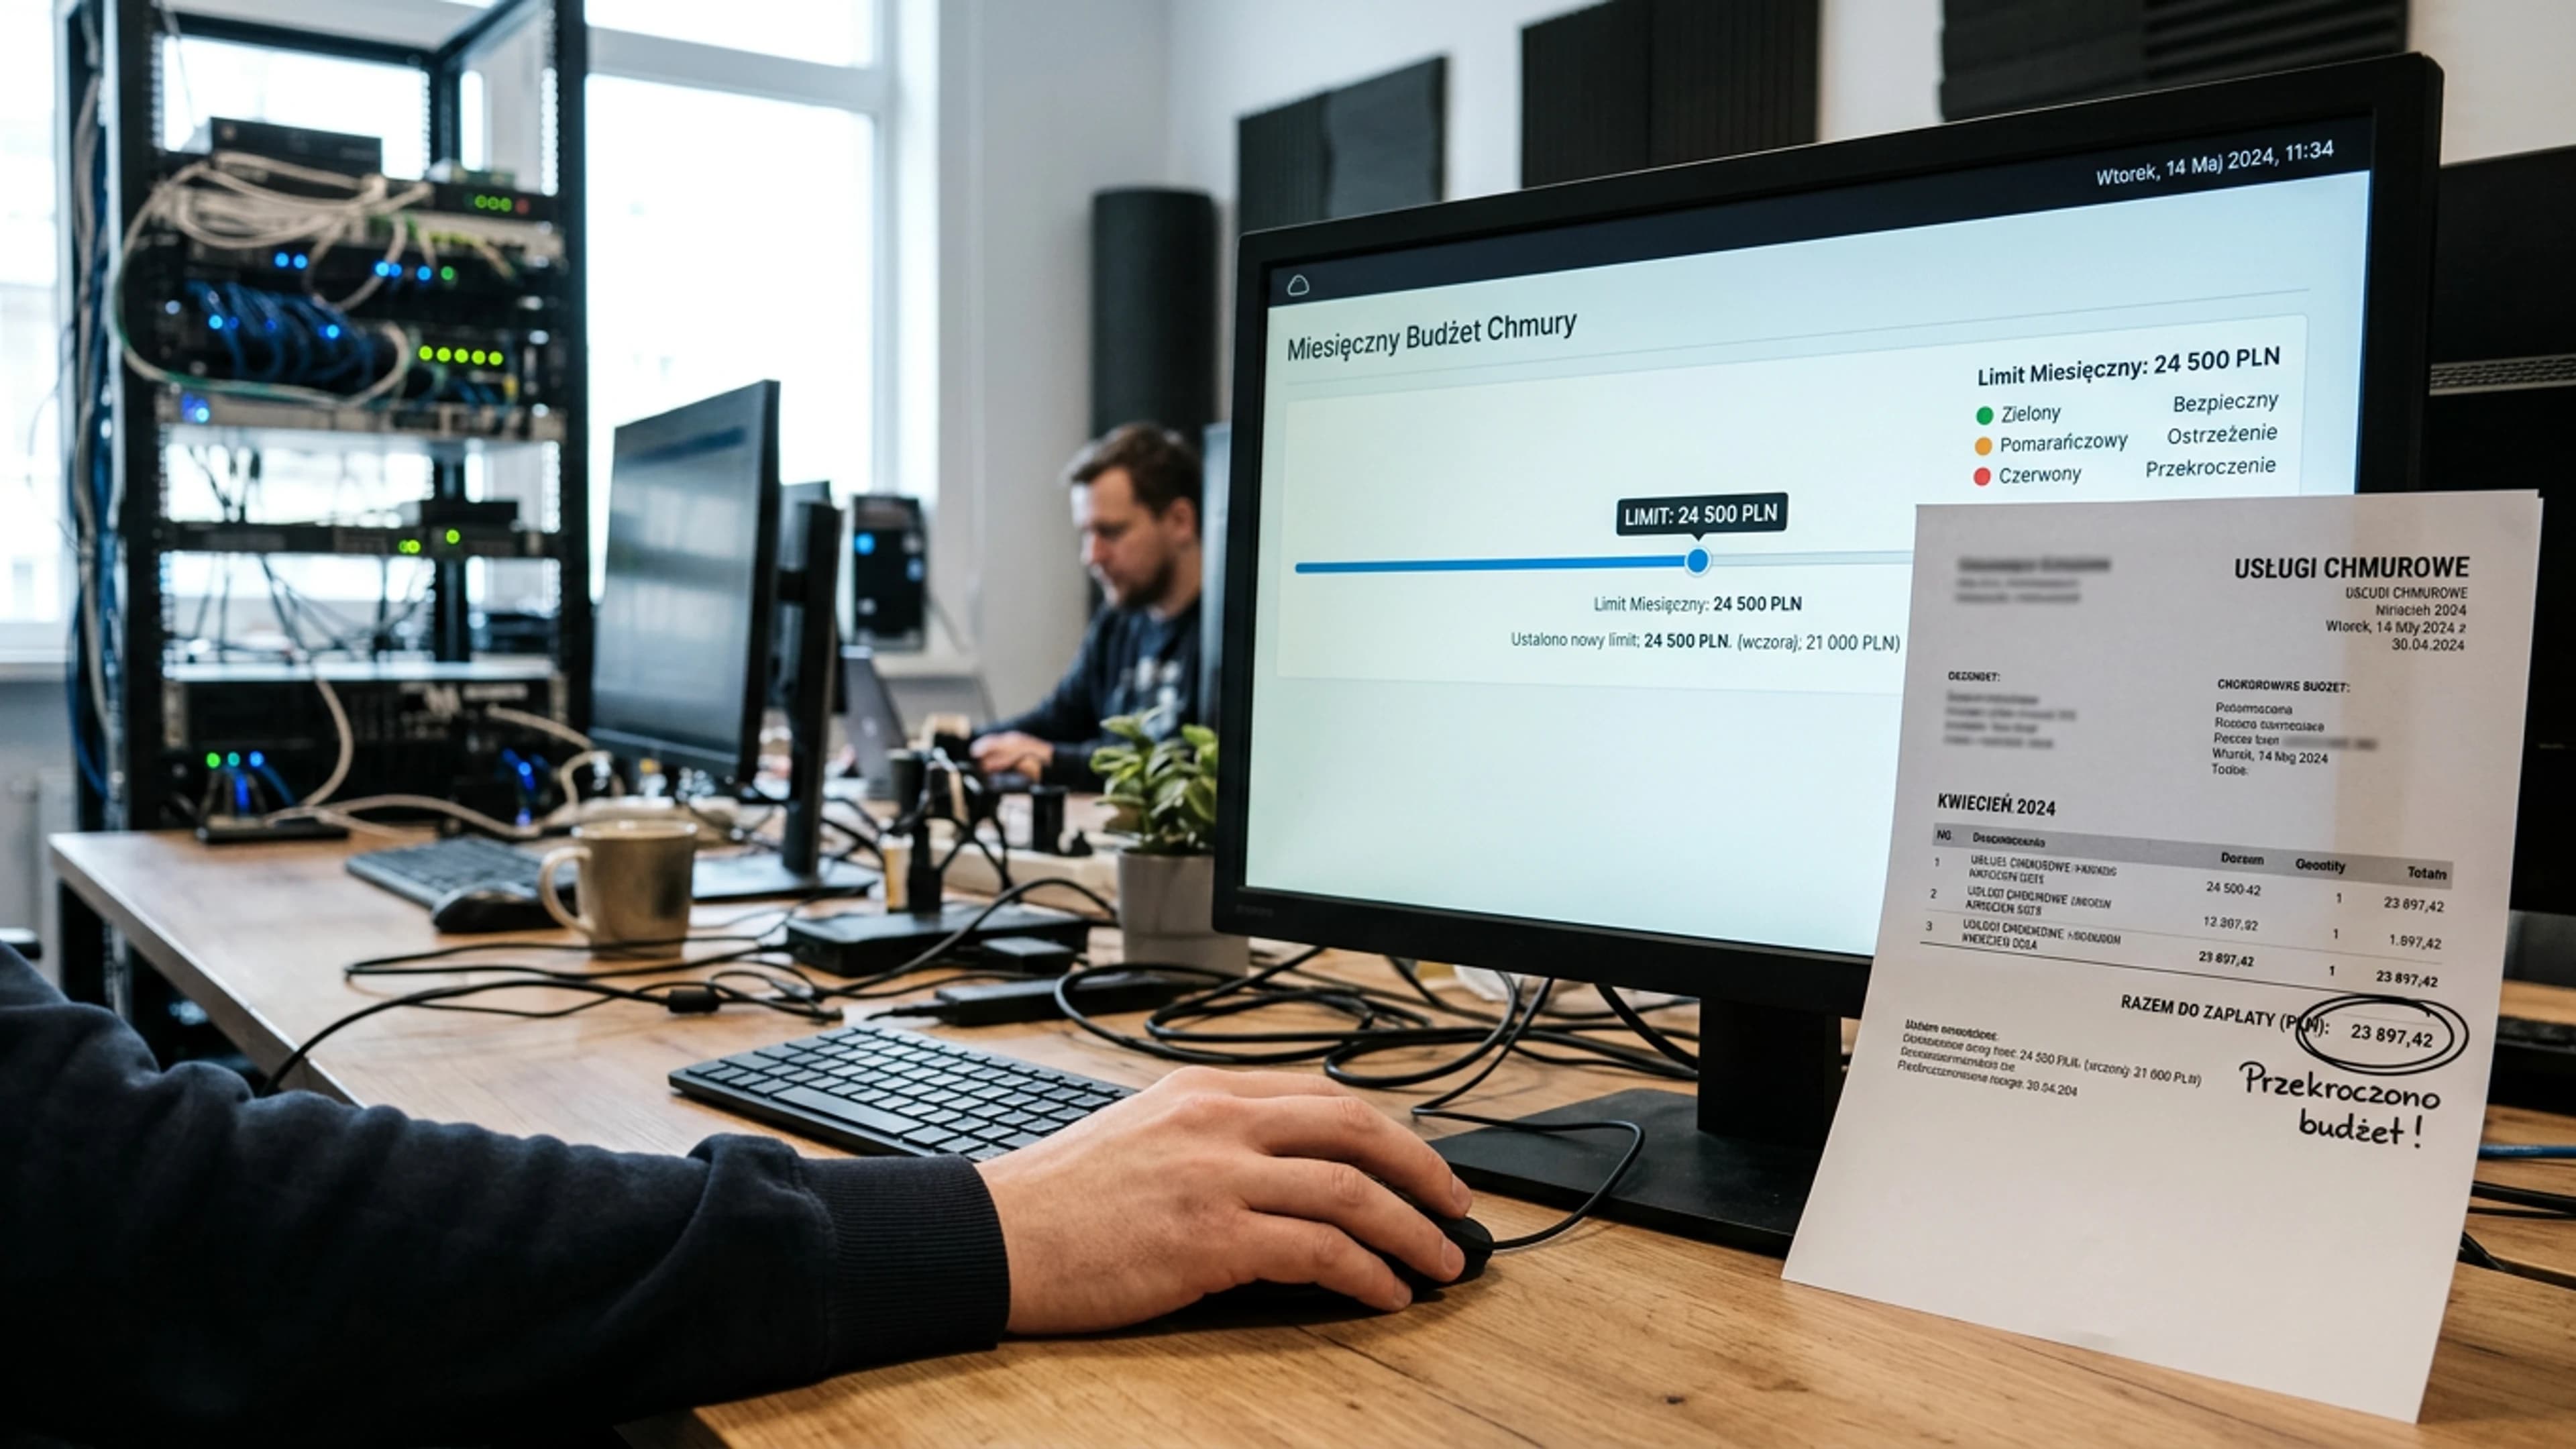
Крок 1: звіт usage у таблицю. Час: 2 години, виконує адміністратор API або DevOps. Експорт із панелі постачальника фільтрується за полями: model, api_key, project_id, cached_tokens, completion_tokens, requests. Дані зводяться у зведену таблицю, щоб побачити, який проєкт і ключ генерують 80% рахунку. Крок 2: жорсткий ліміт та сповіщення в консолі. Час: 30 хвилин, виконує власник платіжного акаунта. В OpenAI налаштовується monthly budget, в Azure Cost Management: бюджет, у Google Cloud Billing: сповіщення, в AWS Budgets: сповіщення. Пороги: 50%, 80%, 100%. На 100% API має повністю зупинитися. Крок 3: prompt caching для повторюваних контекстів. Час: 2–4 години, виконує інженер додатків. Достатньо не надсилати ту саму системну інструкцію знову та налаштувати cache TTL там, де це передбачено документацією. Орієнтовна економія: 30–90% витрат на вхідні токени. Крок 4: менша модель для завдань із низьким ризиком. Час: 1 день, виконує продуктова команда з розробником. Скорочення листів, категоризація, чернетки пропозицій переводяться на GPT-4o mini, Claude Haiku або Gemini Flash, а ведення переговорів та аналіз договорів залишаються на більшій моделі. Тарифи для моделей Anthropic наведено в офіційному прайс-листі. Крок 5: окремі API-ключі для кожної команди. Час: 2 години, виконує IT Manager. Для кожної команди створюється новий ключ і ліміт витрат. Завдяки цьому сплеск від одного циклу повторних спроб retry не губиться в загальному рахунку.
Чого не робити одразу
Перша реакція: купівля платформи для моніторингу витрат на AI або шлюзу LLM. Вартість такого впровадження зазвичай становить 4 000–15 000 PLN і два тижні інтеграції, а проблемою цього тижня найчастіше виявляється один цикл повторних спроб retry після коду 429. Друга помилка: глобальний перехід на найменшу модель. У завданнях польською мовою GPT-4o mini, Claude Haiku та Gemini Flash добре справляються з категоризацією та скороченнями текстів, але можуть спотворювати дати або суми в пропозиціях. Третя помилка: один жорсткий ліміт на всю компанію, який у п'ятницю о 16:40 заблокує продакшн, а не лише експеримент. Натомість ліміти встановлюються окремо для кожного ключа, проєкту та команди. Четверта помилка: міграція постачальника або переговори в перший же тиждень. Без звіту usage говорити нема про що. П'ята помилка: вимкнення Batch API та нічної обробки, де тариф буває на 50% нижчим, і це часто єдине, що утримує бюджет.
Як перевірити ефективність за два тижні
Через два тижні розрахуйте витрати на 1 млн вхідних і вихідних токенів у проєкті, який раніше генерував найбільший рахунок. У таблиці розділіть плату на суму вхідних і вихідних токенів із поля usage. Орієнтир для меншої моделі для польської мови за курсом від 24.04.2026 (1 USD = 3,78 PLN, джерело NBP, суми нетто) становить 0,70–0,90 PLN за 1 млн токенів входу й виходу разом. Якщо до змін було 2,40 PLN, а після ввімкнення кешування та заміни моделі витрати знизилися до 1,10 PLN, економія становить 54%. Поріг для відкату: якщо витрати на 1 млн токенів не впали нижче 1,20 PLN або частка запитів із помилкою 429 Too Many Requests усе ще перевищує 5% від загальної кількості, поверніть попередню модель і перевірте, чи кеш дійсно повертає попадання.
Якщо у вас немає часу на формування звіту та конфігурацію лімітів, HEXART реалізує це як швидкий спрінт: 3–5 робочих днів. Починаємо з вивантаження usage за кожним проєктом і ключем, далі налаштовуємо бюджети, сповіщення та правила кешування. У результаті ви отримуєте контрольну таблицю для щопонеділкового моніторингу. Деталі: https://hexart.pl/uslugi.
Джерела інформації
Матеріали, які ми використовували під час написання. Текст вище належить нам. Ці сайти не несуть відповідальності за його зміст і не авторизували його.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury
