Intégrations et données20:05
D'où proviennent 14 200 PLN sur une facture API
Découvrez comment repérer en une semaine dans les journaux d'utilisation l'origine d'une hausse de facture API, instaurer des limites strictes et des alertes, puis réduire les dépenses de 35–60% sans nouveaux outils.
Écouter le résumé de l'article
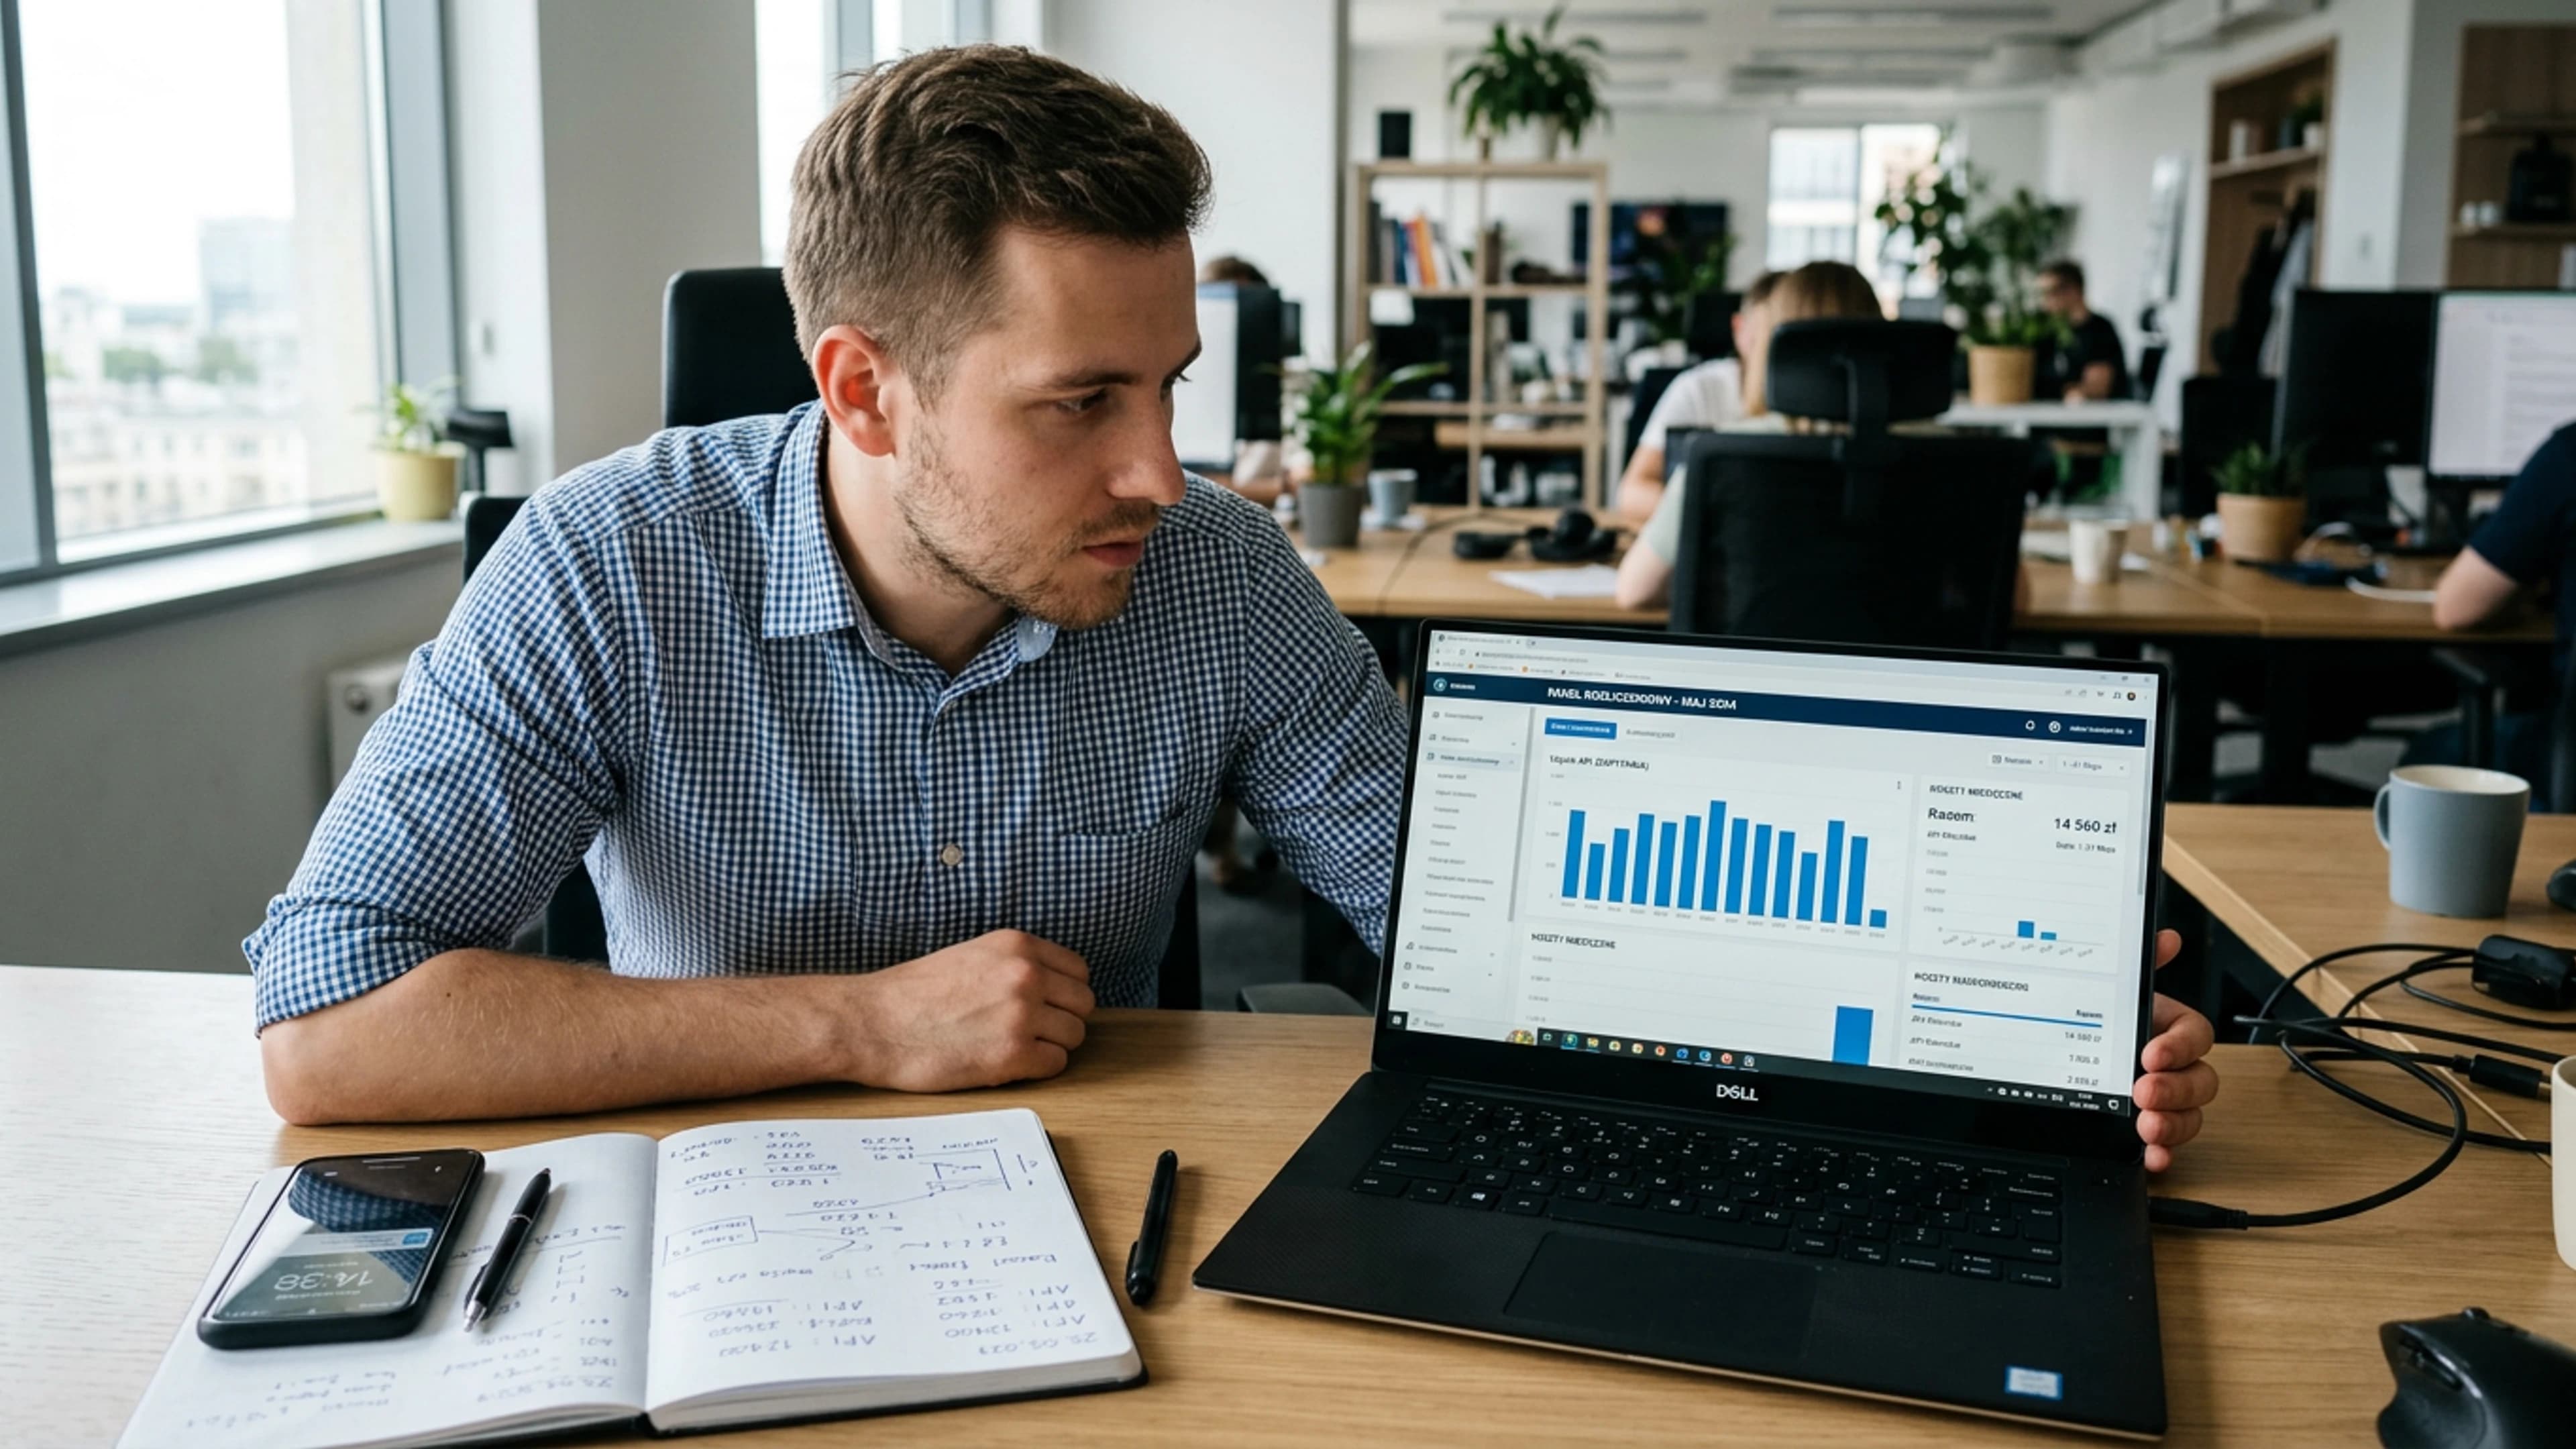
Voix synthétique.Nous partageons notre expérience du terrain : gratuitement et sans présumer que votre cas soit identique. Dans une entreprise commerciale de 70 collaborateurs, le service client utilise depuis janvier un assistant pour résumer les e-mails et préparer les devis. Sur la facture de mars du fournisseur d'API s'affiche un montant de 14 200 PLN net au lieu de 2 100 PLN. Le code n'a pas changé, aucune nouvelle fonctionnalité n'a été déployée. Cette hausse provient de trois facteurs visibles dans le tableau de bord d'usage : les tokens d'entrée augmentent avec l'historique de conversation, une requête dépassant la limite boucle en continu, et une seule clé API sert à cinq équipes sans budget par projet.
La facture d'API correspond à l'addition de plusieurs éléments : tokens d'entrée (tout l'historique transmis), tokens de sortie (le contenu généré), reasoning tokens, tool calling, structured output ainsi que les images ou l'audio selon le traitement du modèle. La mécanique d'un tour de conversation reste simple : coût du tour = somme des tokens d'entrée de tout l'historique × tarif d'entrée + tokens générés × tarif de sortie. Ainsi, échanger avec un document de 20 000 tokens coûte quelques centimes, mais le même échange intégrant tout le fil atteint 200 000 tokens et épuise le budget avant même que le modèle n'écrive la première phrase. Les tarifs officiels d'OpenAI figurent sur la grille tarifaire, et le calcul des tokens est détaillé dans la documentation.
Ce qui peut être fait cette semaine
Action 1 : exporter l'usage vers un tableur. Temps : 2 heures, réalisé par l'administrateur API ou DevOps. L'export depuis le panneau du fournisseur filtre par champs : model, api_key, project_id, cached_tokens, completion_tokens, requests. Structurez en tableau croisé dynamique pour isoler le projet et la clé responsables de 80 % de la facture. Action 2 : fixer des limites strictes et des alertes dans la console. Temps : 30 minutes, réalisé par le propriétaire du compte de facturation. Configurez le budget mensuel dans OpenAI, le budget dans Azure Cost Management, l'alerte dans Google Cloud Billing, l'alerte dans AWS Budgets. Seuils : 50 %, 80 %, 100 %. À 100 %, l'API doit être coupée net. Action 3 : activer le prompt caching sur les contextes récurrents. Temps : 2–4 heures, réalisé par l'ingénieur applicatif. Évitez de renvoyer l'instruction système à chaque appel et paramétrez le cache TTL selon la documentation. Économie estimée : 30–90 % sur les dépenses de tokens d'entrée. Action 4 : router vers un modèle plus léger sur les tâches à faible risque. Temps : 1 jour, réalisé par l'équipe produit avec un développeur. Résumés d'e-mails, catégorisation et premiers jets de devis basculent sur GPT-4o mini, Claude Haiku ou Gemini Flash, tandis que les négociations et analyses de contrats restent sur un modèle plus robuste. Les tarifs d'Anthropic figurent sur la grille tarifaire officielle. Action 5 : attribuer des clés API distinctes par équipe. Temps : 2 heures, réalisé par l'IT Manager. Une clé dédiée et une limite de dépense pour chaque pôle. Le pic causé par une boucle de retry n'est plus noyé dans la facture globale.
Ce qu'il ne faut pas faire immédiatement
Le premier réflexe consiste à acheter une plateforme de suivi des coûts de l'IA ou une passerelle LLM. Un tel déploiement coûte généralement 4 000–15 000 PLN et exige deux semaines d'intégration, alors que le problème de la semaine se résume le plus souvent à une simple boucle de nouvelle tentative après une erreur 429. La deuxième erreur consiste à basculer globalement vers le plus petit modèle. Pour des tâches en polonais, GPT-4o mini, Claude Haiku et Gemini Flash gèrent bien la catégorisation et les synthèses, mais peuvent déformer des dates ou des montants dans une offre. La troisième erreur est d'imposer une limite stricte unique pour toute l'entreprise : un vendredi à 16:40, elle bloquera la production et pas seulement une expérimentation. Les limites se définissent plutôt par clé, par projet et par équipe. La quatrième erreur consiste à changer de fournisseur ou à négocier dès la première semaine ; sans rapport d'utilisation, il n'y a rien à négocier. La cinquième erreur est de désactiver la Batch API et les traitements nocturnes, alors que les tarifs y sont souvent 50% plus bas et constituent fréquemment le seul rempart du budget.
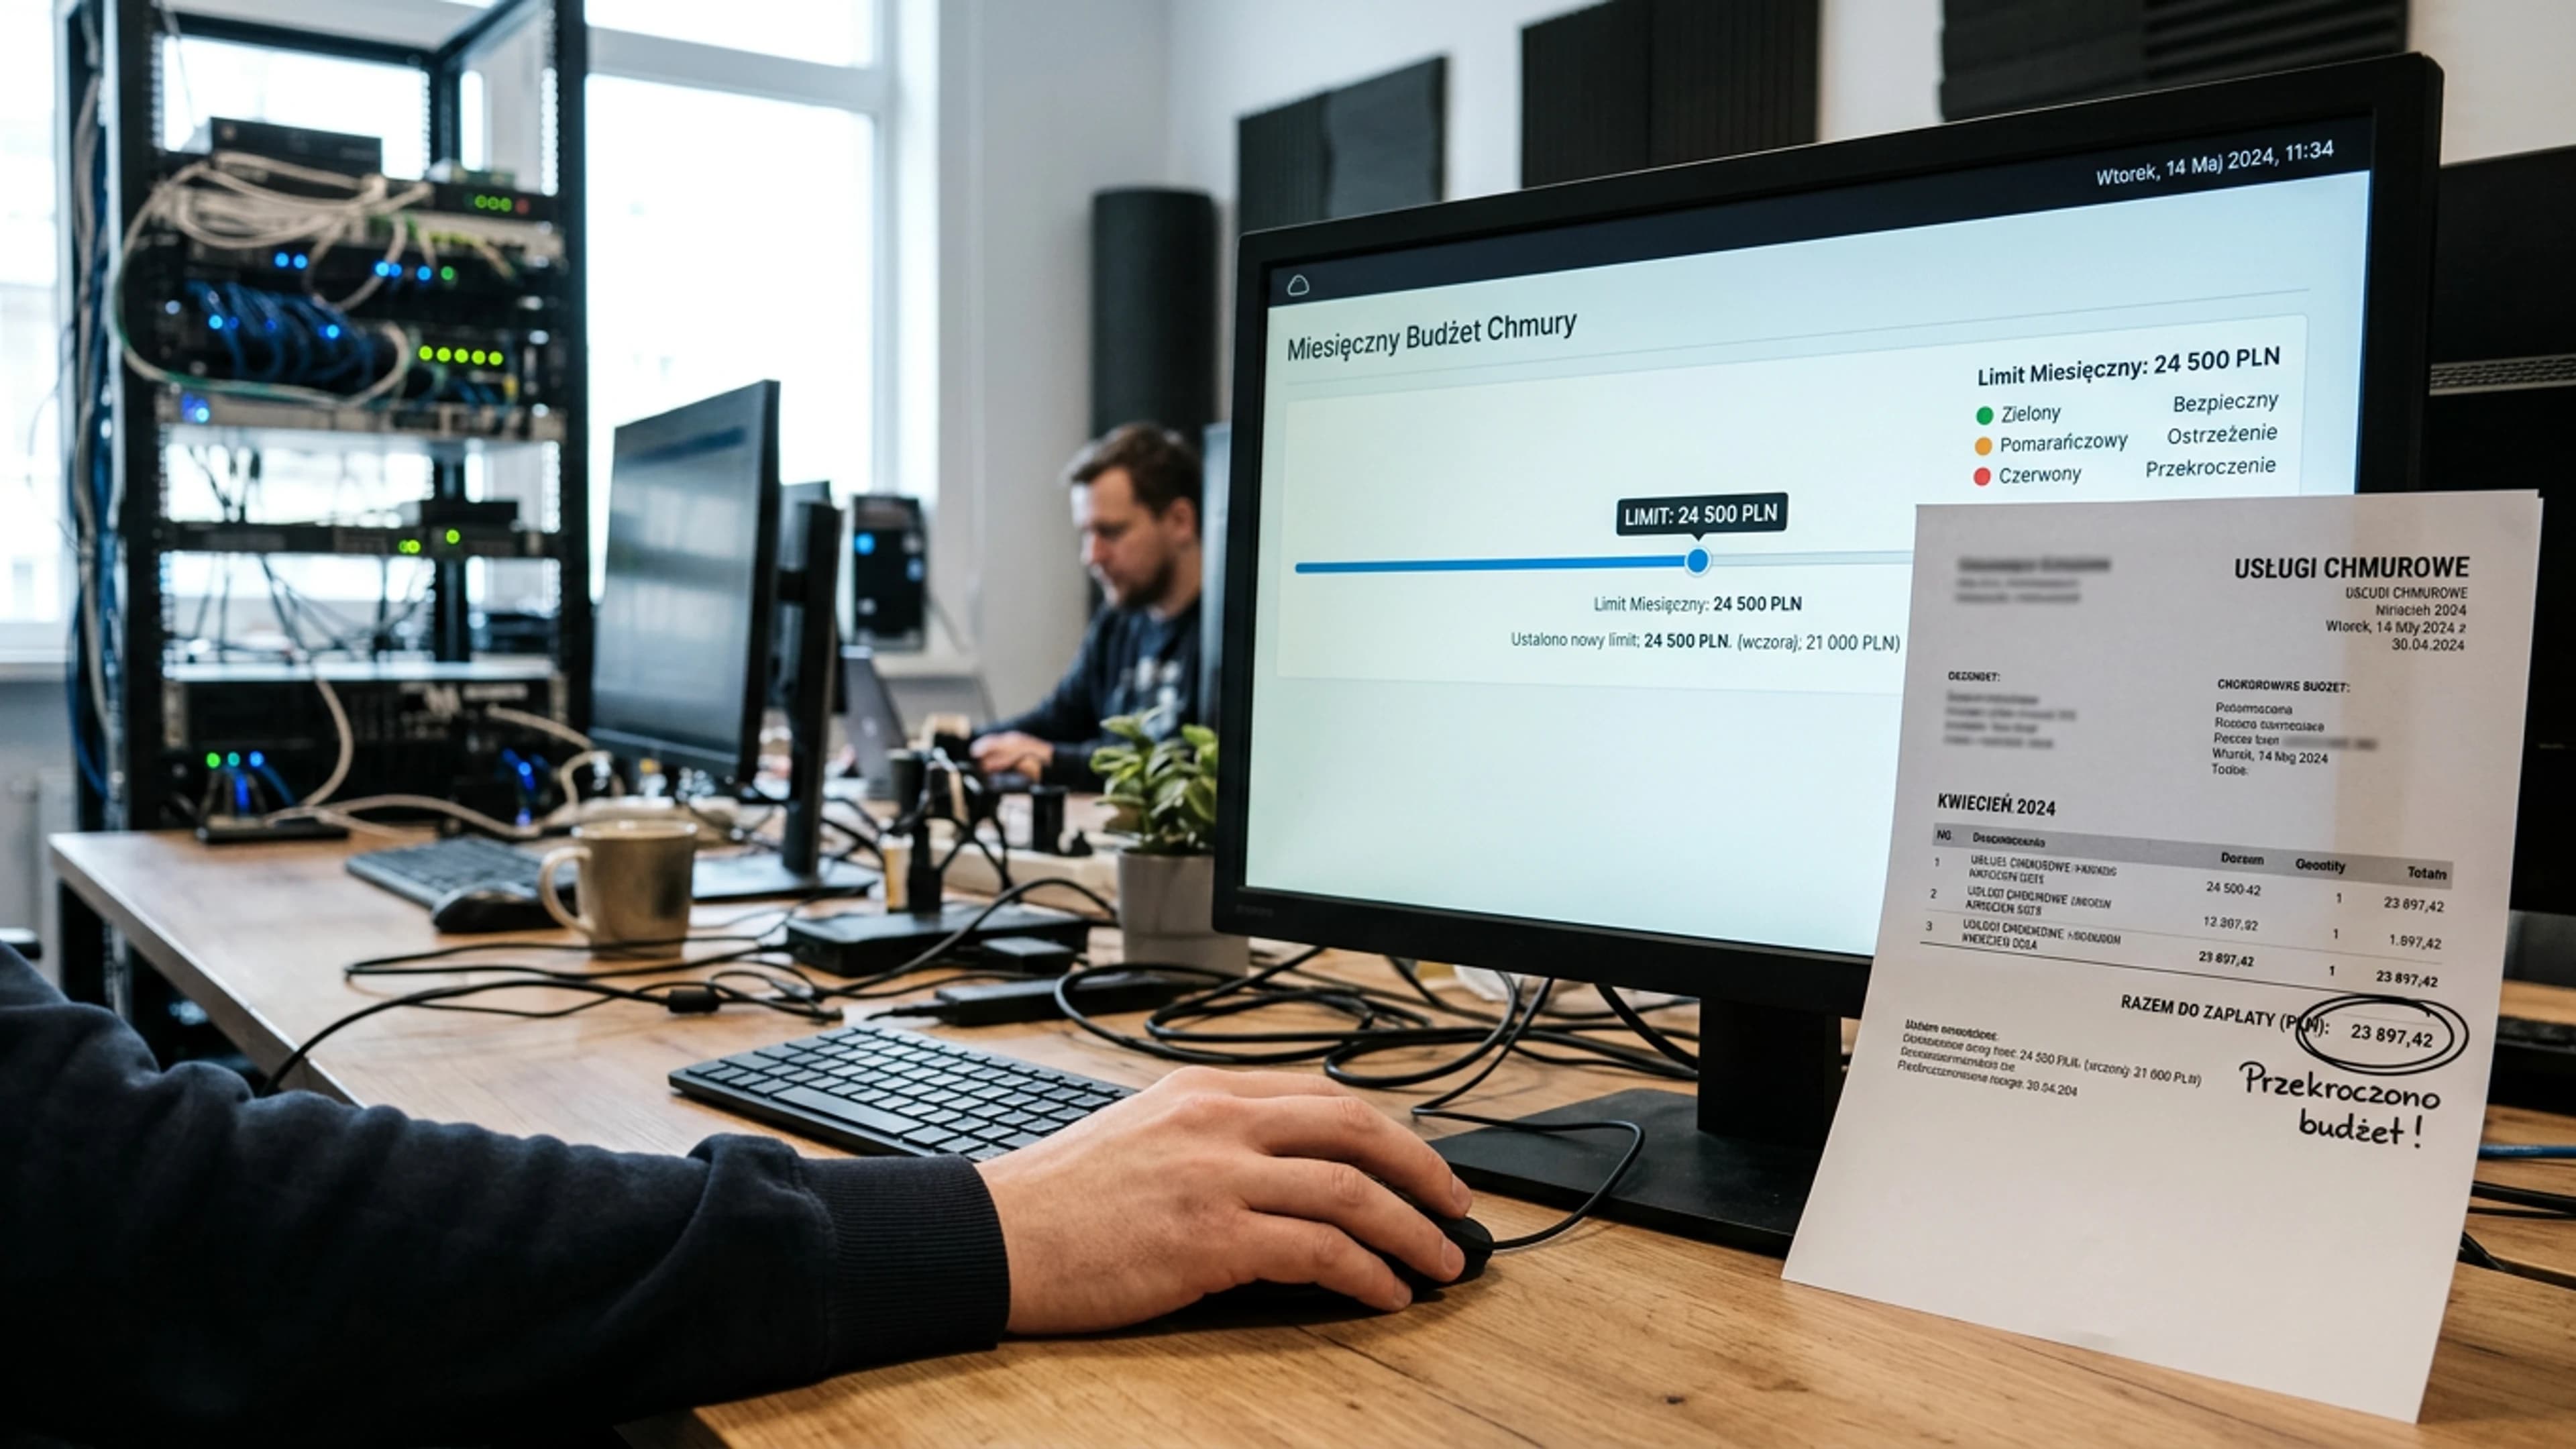
Comment vérifier l'efficacité au bout de deux semaines
Au bout de deux semaines, calculez le coût pour 1 million de tokens d'entrée et de sortie sur le projet qui générait la plus grosse facture. Dans une feuille de calcul, divisez le montant facturé par la somme des tokens d'entrée et de sortie issue du champ usage. La valeur de référence pour un modèle plus léger en polonais, selon le taux de change du 24.04.2026 (1 USD = 3,78 PLN, source NBP, montants nets), s'élève à 0,70–0,90 PLN pour 1 million de tokens entrée et sortie cumulées. Si le coût atteignait 2,40 PLN avant optimisation et tombe à 1,10 PLN après activation du cache et remplacement du modèle, l'économie atteint 54%. Seuil de retour en arrière : si le coût pour 1 million de tokens ne descend pas sous 1,20 PLN ou si le taux de requêtes 429 Too Many Requests dépasse toujours 5% du total, rétablissez le modèle précédent et vérifiez si le cache génère réellement des succès.
Si vous manquez de temps pour établir le rapport et paramétrer les limites, HEXART intervient rapidement : 3–5 jours de travail, en débutant par l'extraction des consommations par projet et par clé, puis en configurant les budgets, alertes et règles de mise en cache. Vous disposez ensuite d'un tableau de suivi opérationnel pour le lundi. Détails : https://hexart.pl/uslugi.
Sources
Documents consultés lors de la rédaction. Le texte ci-dessus est le nôtre; ces plateformes ne sont pas responsables de son contenu et ne l'ont pas validé.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury
