Integrações e dados20:05
Origem de 14 200 PLN na fatura da API
Mostramos como detetar nos registos de utilização, numa semana, a origem do aumento da fatura da API, definir limites rígidos e alertas, e reduzir despesas em 35–60 por cento sem ferramentas novas.
Ouça o resumo do artigo
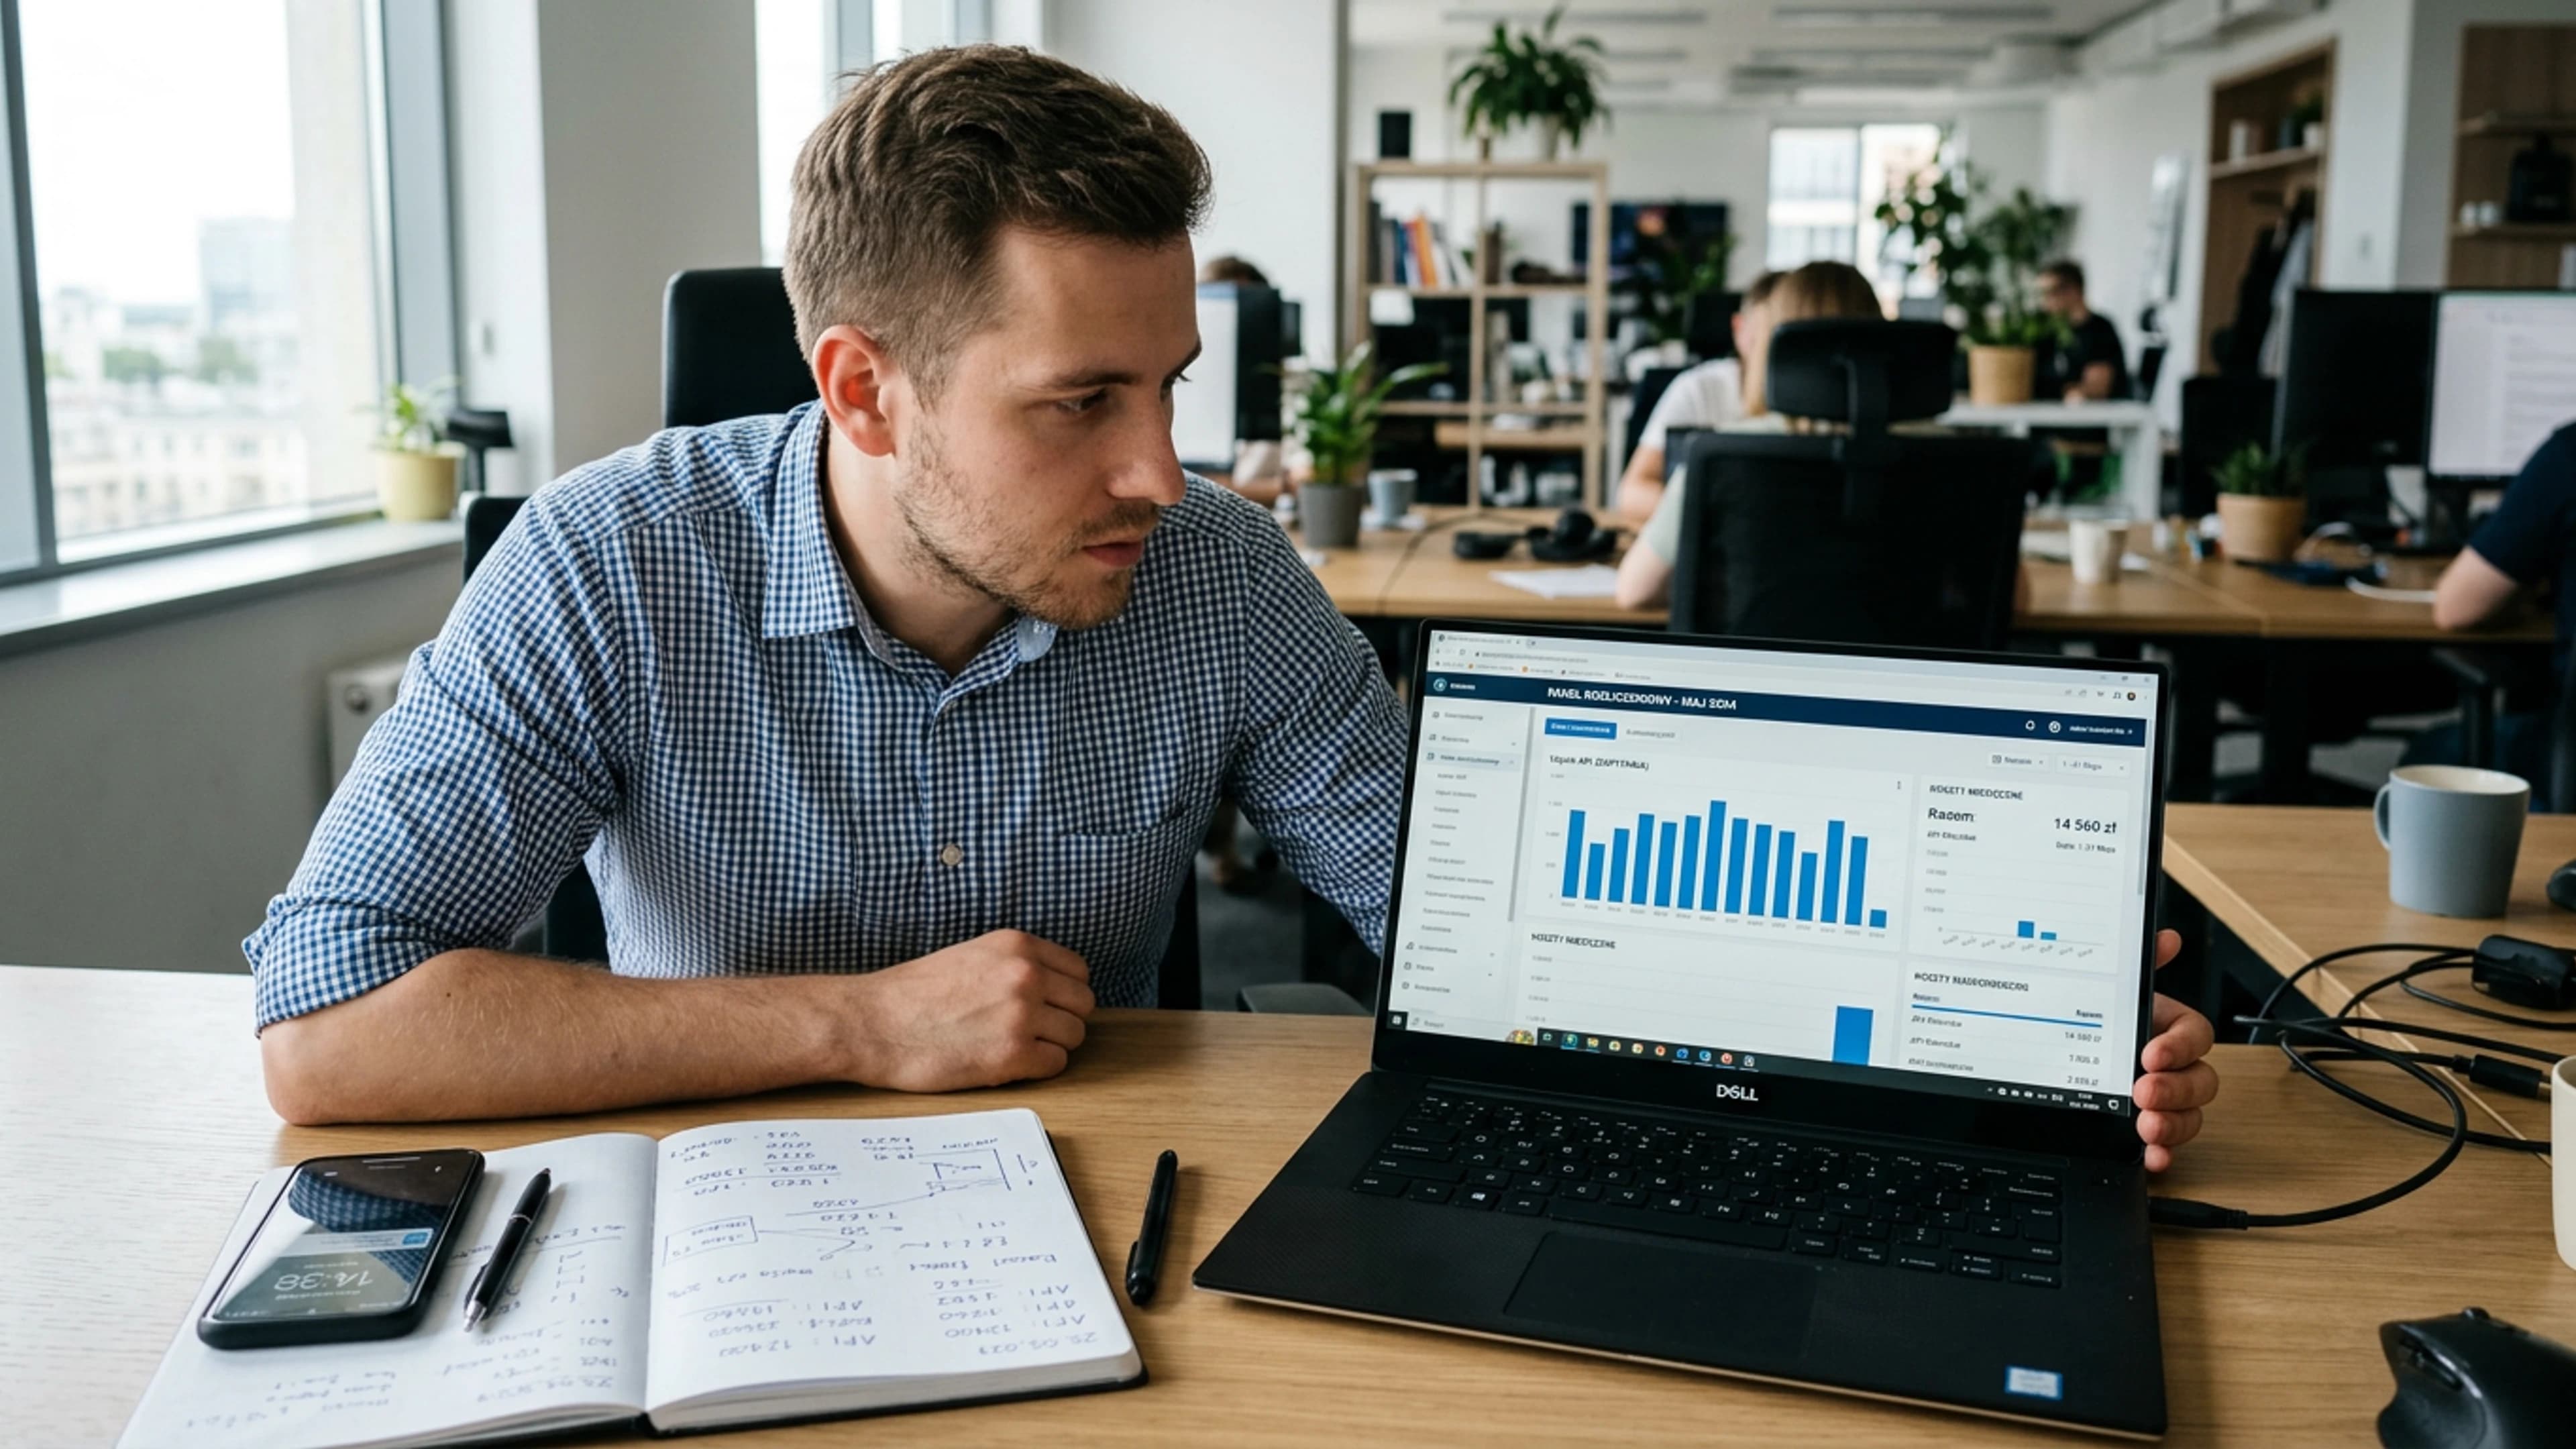
Voz sintética.Partilhamos o que testámos nas nossas próprias implementações: gratuitamente e sem assumir que o seu caso seja idêntico. Numa empresa comercial de 70 pessoas, a equipa de apoio ao cliente utiliza desde janeiro um assistente que resume e-mails e elabora propostas. Na fatura de março do fornecedor da API surgem 14 200 PLN net em vez de 2 100 PLN. O código não mudou, ninguém lançou novas funcionalidades. Este pico tem origem em três campos visíveis no painel de utilização: os tokens de entrada aumentam com o histórico da conversa, um pedido com limite excedido entra em ciclo de repetição e uma única chave de API serve cinco equipas sem orçamentos por projeto.
A fatura da API reflete a soma de vários elementos: tokens de entrada (todo o histórico enviado), tokens de saída (conteúdo gerado), reasoning tokens, tool calling, structured output e imagens ou áudio, se o modelo os processar. A mecânica de cada interação é simples: custo da interação = soma dos tokens de entrada de todo o histórico × taxa de entrada mais tokens gerados × taxa de saída. Por isso, conversar com um documento de 20 mil tokens custa cêntimos, mas a mesma conversa com o histórico completo atinge 200 mil tokens e esgota o orçamento antes da primeira frase do modelo. Os valores oficiais da OpenAI constam da tabela de preços, e a contagem de tokens está descrita na documentação.
O que pode ser implementado esta semana
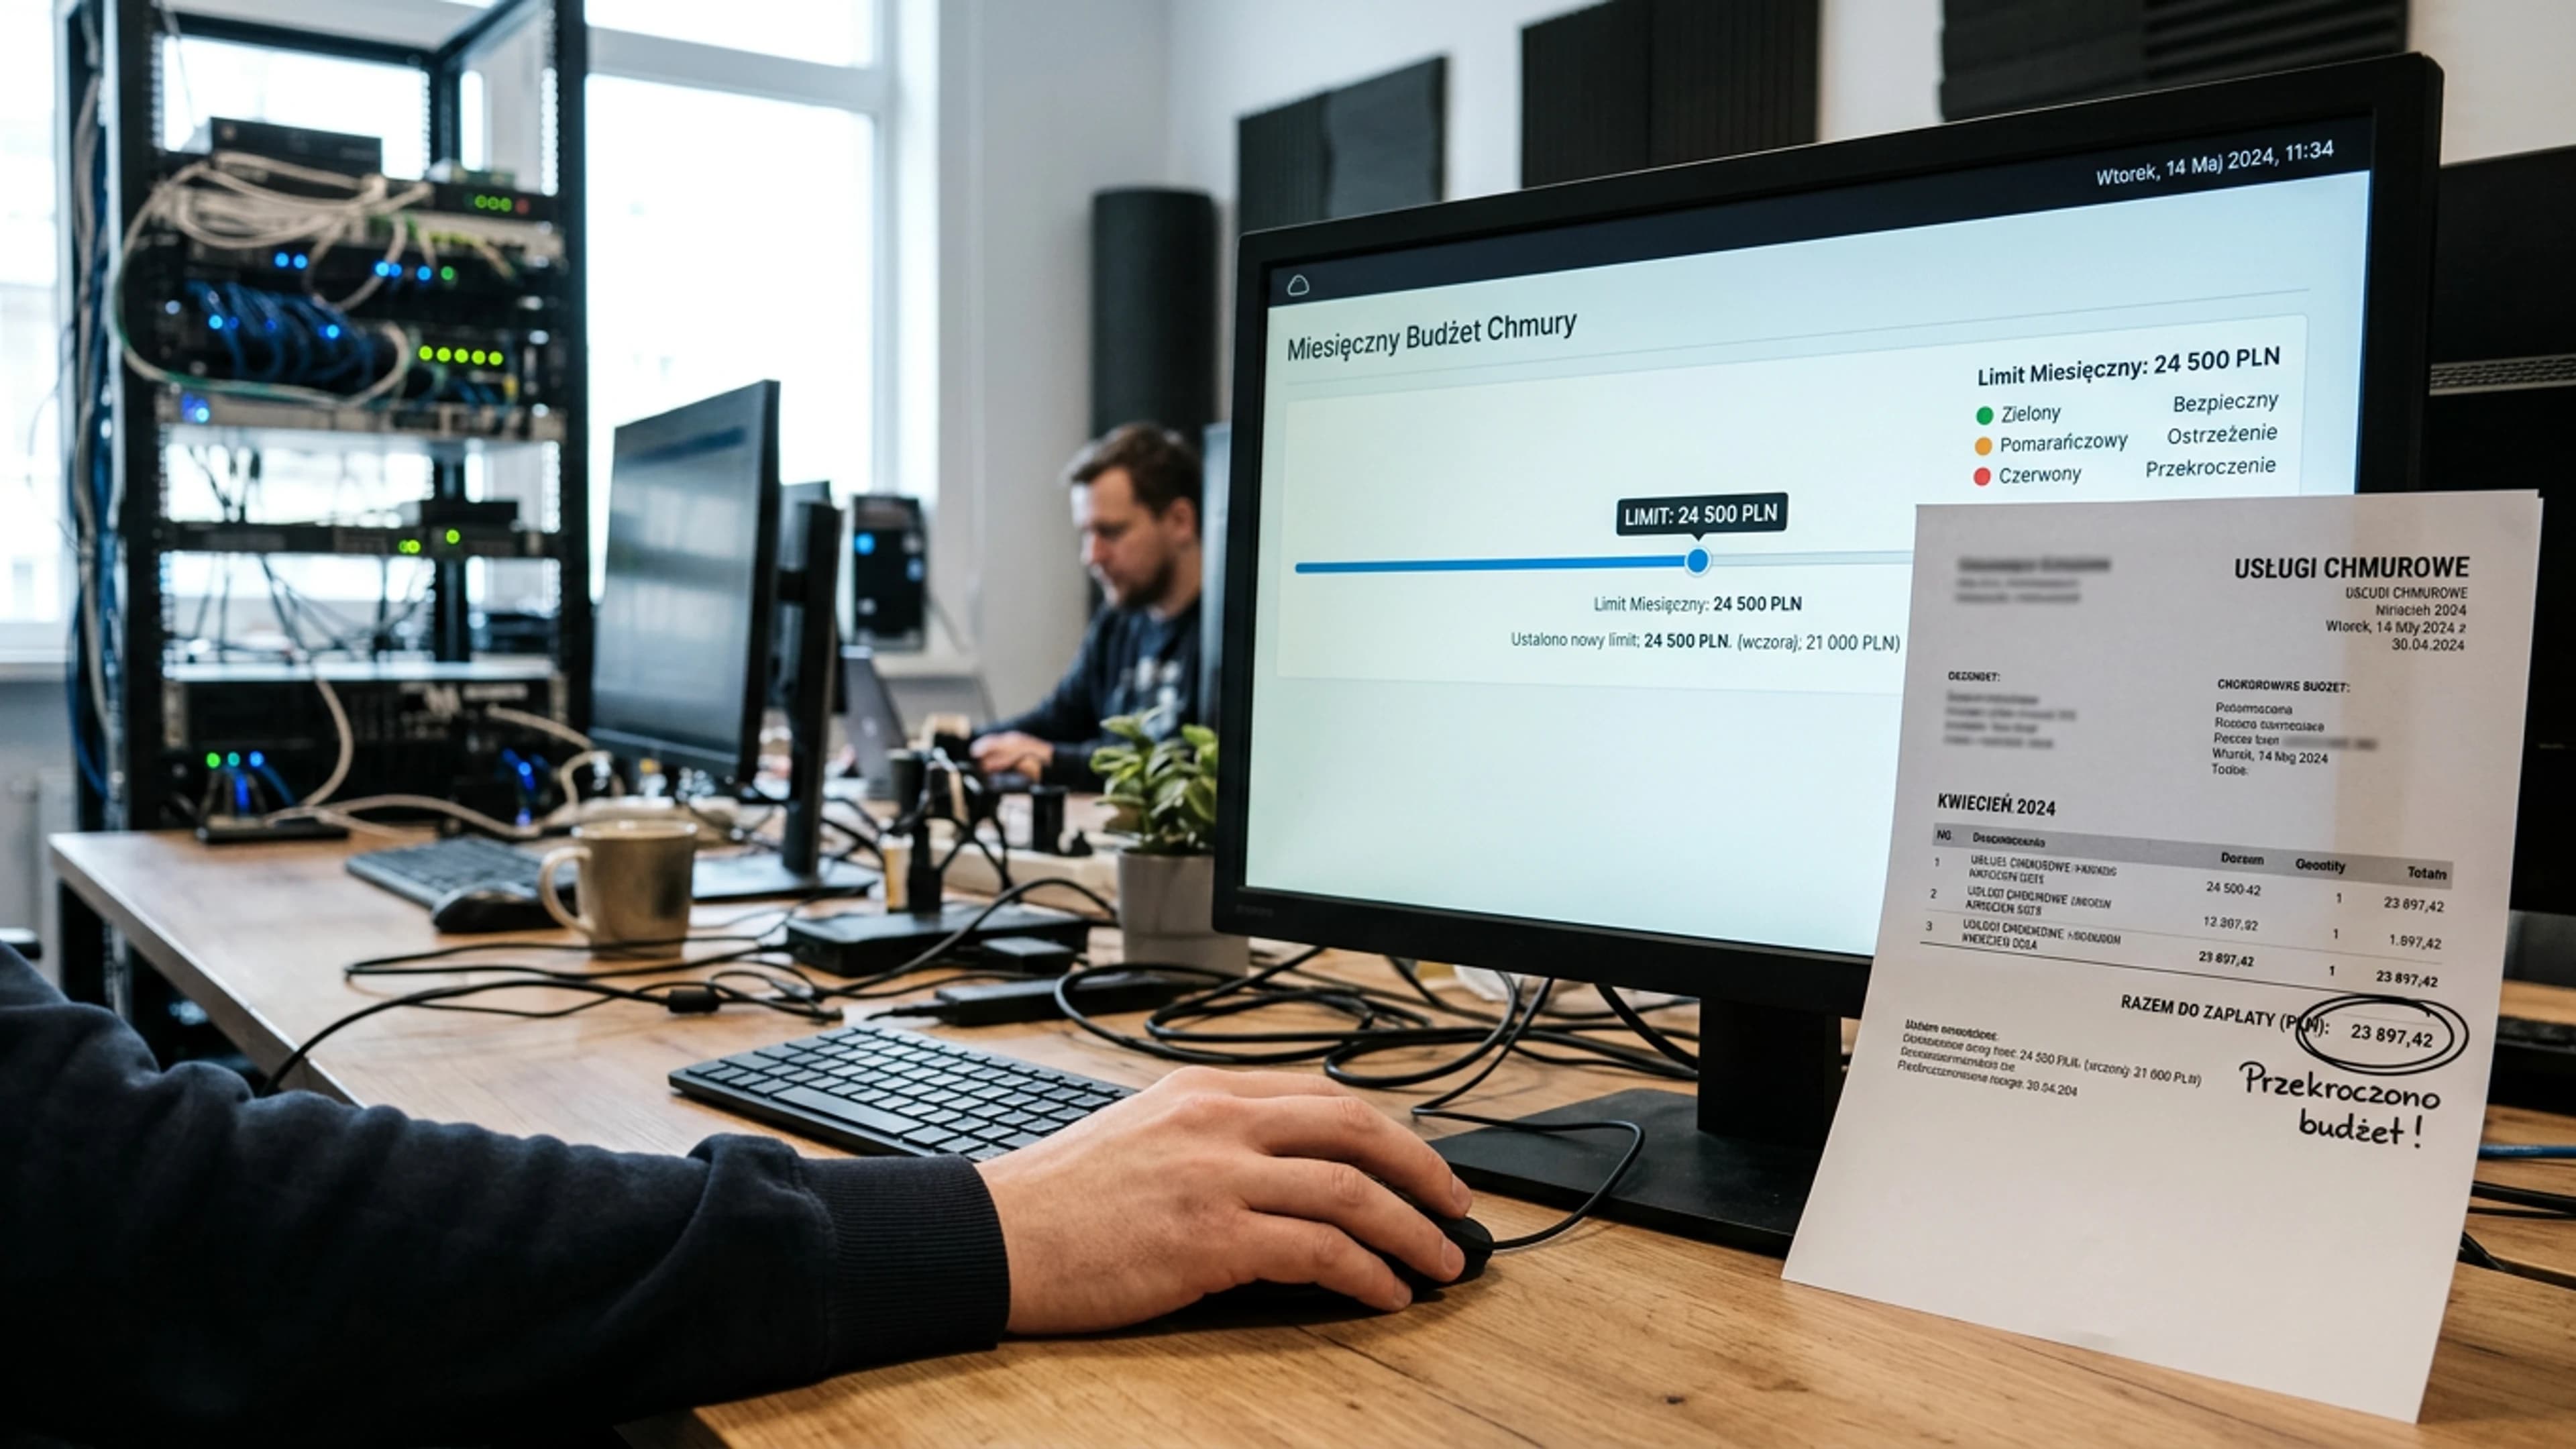
Passo 1: relatório de utilização para uma folha de cálculo. Tempo: 2 horas, executado pelo administrador da API ou DevOps. O ficheiro exportado do painel do fornecedor filtra pelos campos: model, api_key, project_id, cached_tokens, completion_tokens, requests. Estrutura numa tabela dinâmica para identificar que projeto e chave geram 80% da fatura. Passo 2: limite rígido e alertas na consola. Tempo: 30 minutos, executado pelo titular da conta de faturação. Na OpenAI define-se um monthly budget, no Azure Cost Management um orçamento, no Google Cloud Billing um alerta, no AWS Budgets um alerta. Limiares: 50%, 80%, 100%. Aos 100%, a API deve parar imediatamente. Passo 3: prompt caching para contextos repetitivos. Tempo: 2–4 horas, executado pelo engenheiro de software. Basta não reenviar a mesma instrução de sistema e definir o TTL da cache onde a documentação o preveja. Poupança estimada: 30–90% do custo dos tokens de entrada. Passo 4: modelo menor em processos de baixo risco. Tempo: 1 dia, executado pela equipa de produto com um programador. Resumos de e-mails, categorização e rascunhos de propostas passam para o GPT-4o mini, Claude Haiku ou Gemini Flash, enquanto conversas de negociação e análise de contratos mantêm-se no modelo maior. Os valores dos modelos Anthropic estão disponíveis na tabela de preços oficial. Passo 5: chaves de API dedicadas por equipa. Tempo: 2 horas, executado pelo Diretor de TI. Uma nova chave e limite de gastos para cada equipa. Assim, um pico originado por um ciclo de tentativas (retry) não se perde na fatura global.
O que não deve fazer de imediato
O primeiro reflexo consiste em adquirir uma plataforma de monitorização de despesas com IA ou um gateway de LLM. O custo desta implementação ronda habitualmente 4 000–15 000 PLN e duas semanas de integração, quando o problema desta semana se resume quase sempre a um ciclo de tentativas repetidas após um código 429. O segundo erro reside na mudança global para o modelo mais pequeno. Em tarefas em polaco, o GPT-4o mini, Claude Haiku e Gemini Flash funcionam bem na categorização e em resumos, mas podem adulterar datas ou valores em propostas. O terceiro erro é aplicar um único limite rígido a toda a empresa: a uma sexta-feira às 16:40, bloqueará a produção em vez de limitar apenas a experiência. Em alternativa, os limites devem ser aplicados por chave, projeto e equipa. O quarto erro envolve migrar de fornecedor ou iniciar negociações logo na primeira semana; sem um relatório de utilização, não há base negocial. O quinto erro é desativar a Batch API e o processamento noturno, onde o valor pode ser 50% inferior, sendo frequentemente o único fator que mantém o orçamento sob controlo.
Como validar os resultados após duas semanas
Após duas semanas, calcula-se o custo por 1 milhão de tokens de entrada e saída no projeto com maior peso na fatura anterior. Na folha de cálculo, divide-se o valor faturado pela soma dos tokens de entrada e saída do campo de utilização. O valor de referência para um modelo menor em polaco, à taxa de câmbio de 24.04.2026 (1 USD = 3,78 PLN, fonte NBP, valores líquidos), situa-se entre 0,70–0,90 PLN por 1 milhão de tokens de entrada e saída combinados. Se o custo antes da alteração era de 2,40 PLN e desceu para 1,10 PLN após ativar a cache e substituir o modelo, a poupança é de 54%. Critério de reversão: caso o custo por 1 milhão de tokens não desça abaixo de 1,20 PLN ou a taxa de pedidos com 429 Too Many Requests continue a exceder 5% do total, reverta para o modelo anterior e confirme se a cache está a registar ocorrências efetivas.
Caso não disponha de tempo para o relatório e para a configuração dos limites, a HEXART intervém de forma ágil: 3–5 dias de trabalho, iniciando pela extração da utilização por projeto e chave, seguindo-se a definição de orçamentos, alertas e regras de cache. No final, entrega-se uma folha de cálculo de controlo para acompanhamento semanal. Detalhes: https://hexart.pl/uslugi.
Fontes
Materiais consultados durante a elaboração deste texto. O conteúdo acima é da nossa autoria; estas páginas não se responsabilizam pelo mesmo nem o autorizaram.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury
