Integrace a data20:05
Odkud se bere 14 200 PLN na faktuře za API
Ukážeme vám, jak během týdne v protokolech využití dohledat zdroj prudkého nárůstu faktury za API, nastavit pevné limity a upozornění a snížit výdaje o 35–60 procent bez nákupu nových nástrojů.
Poslechněte si shrnutí článku
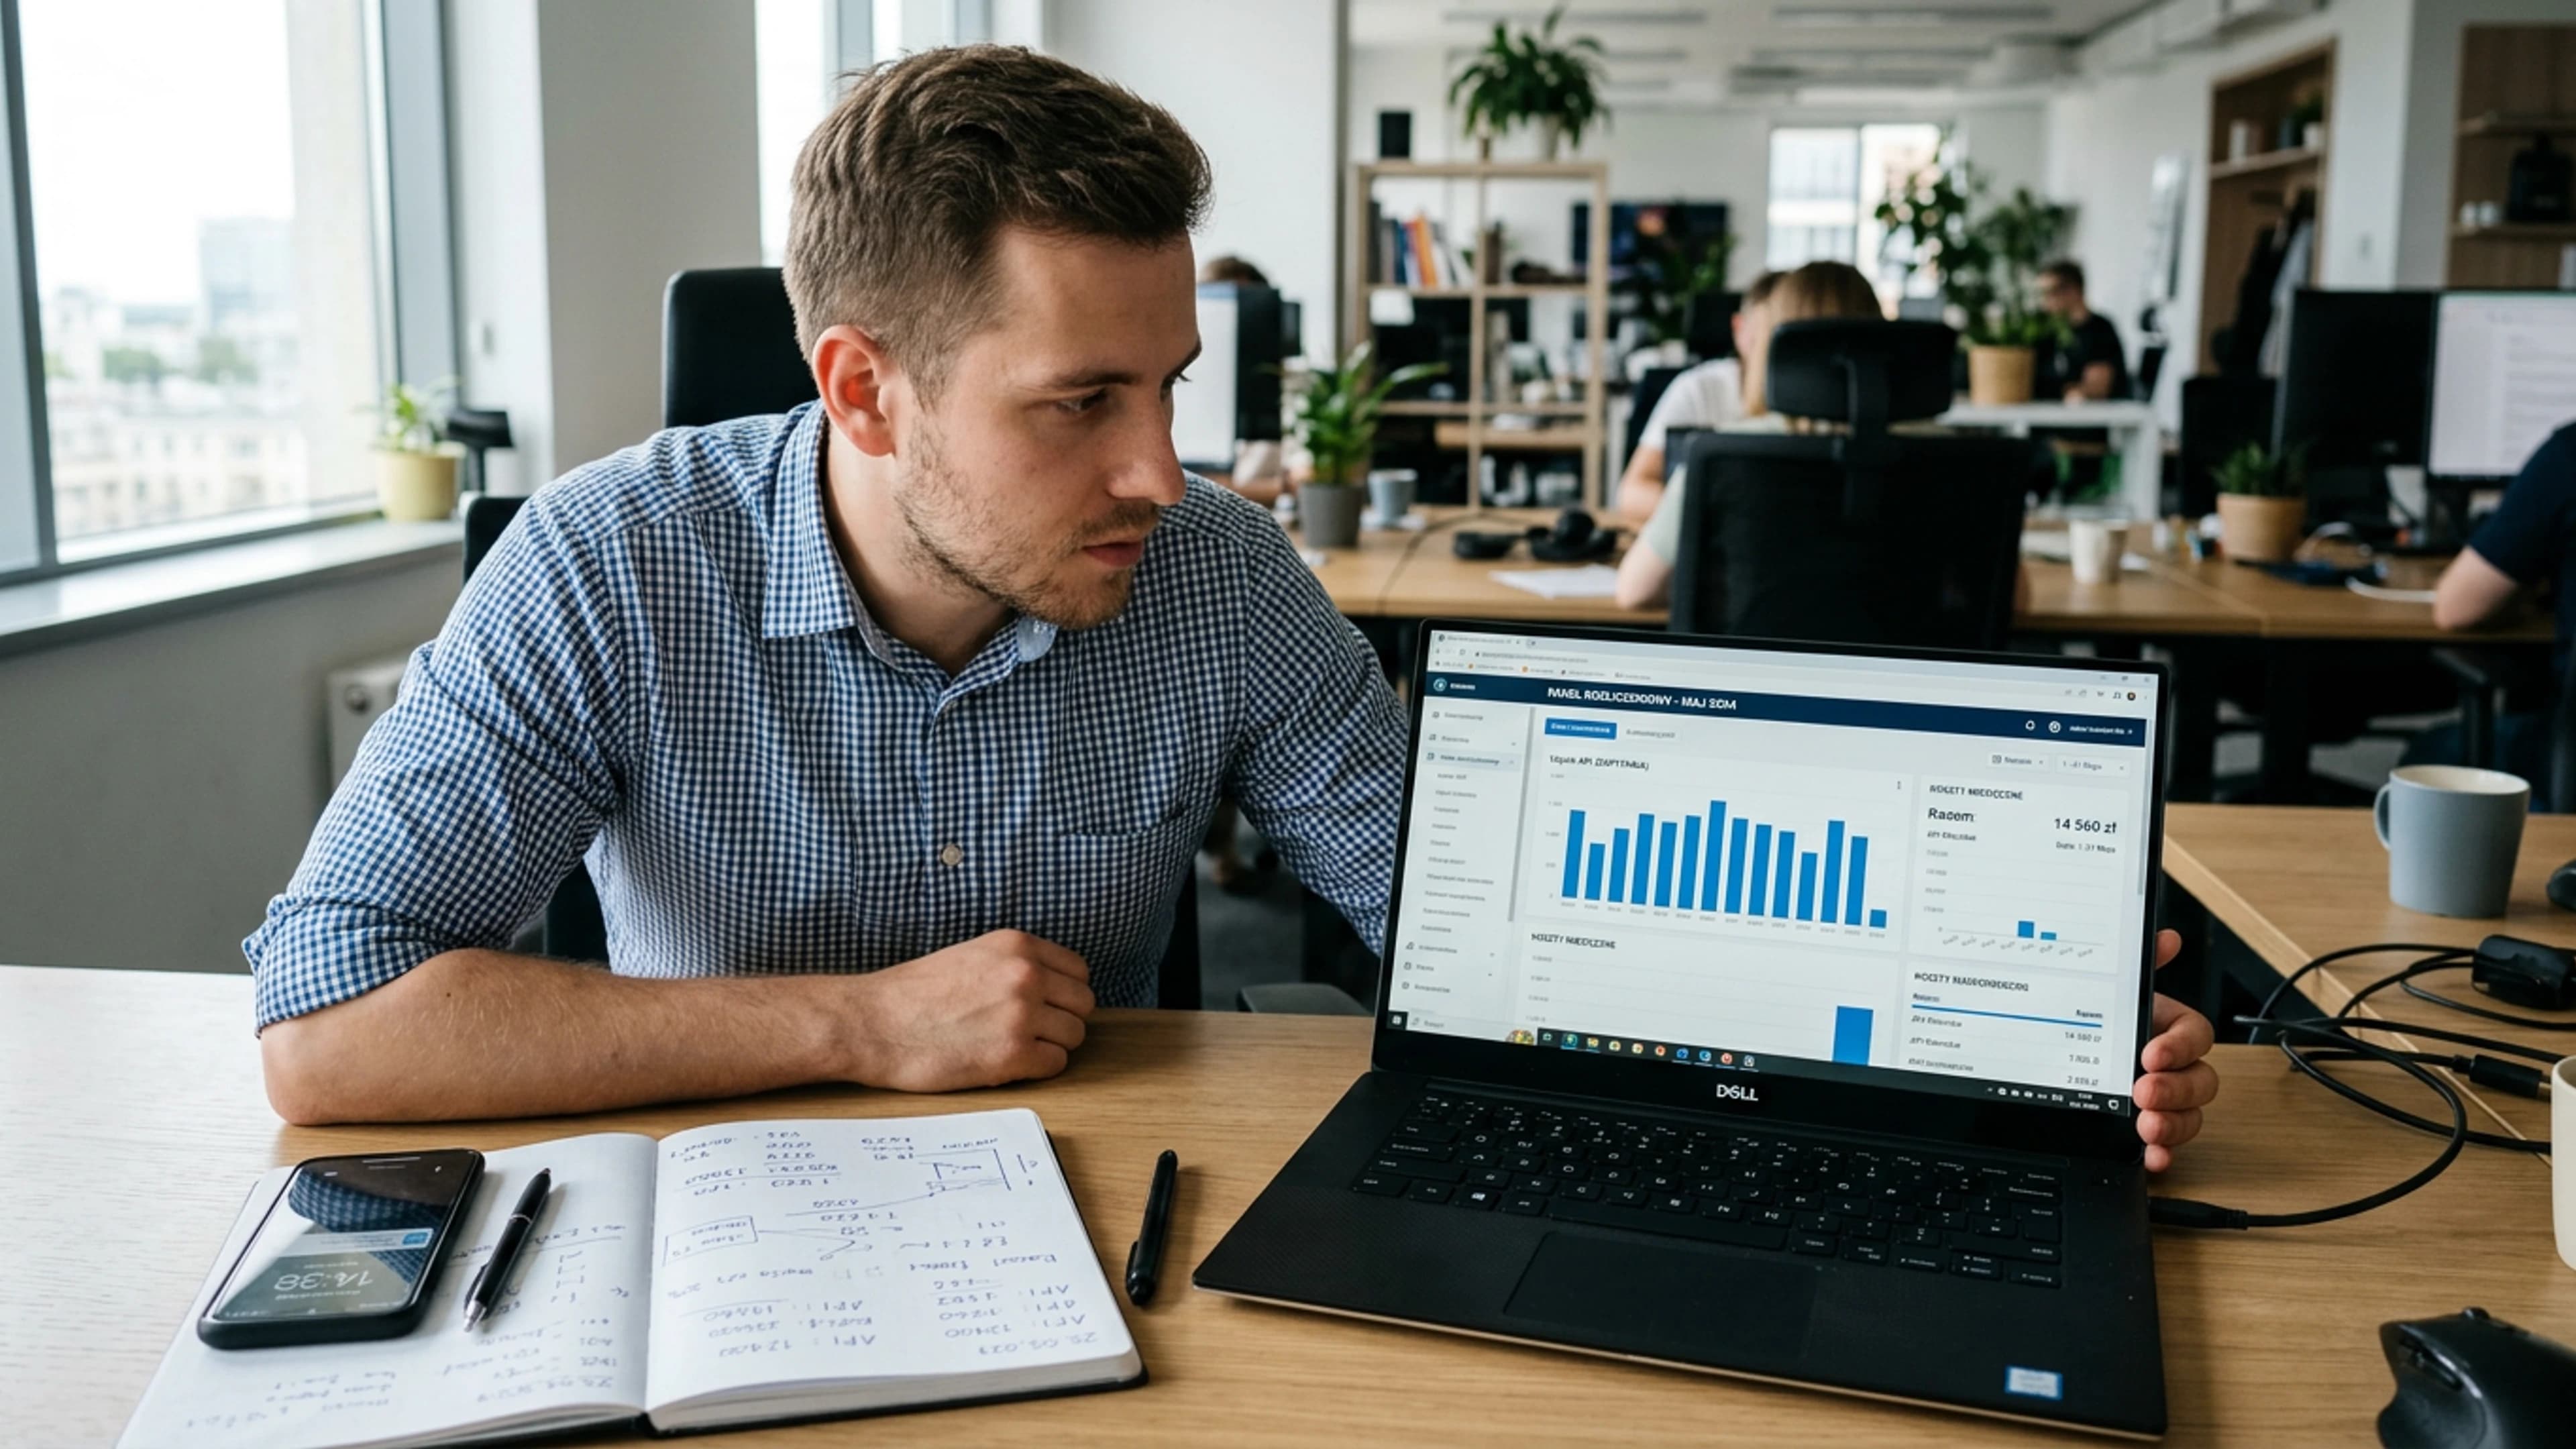
Syntetický hlas.Sdílíme poznatky, které jsme sami ověřili při implementacích: zdarma a bez předpokladu, že váš případ vypadá naprosto stejně. V obchodní firmě o 70 lidech používá tým zákaznické podpory od ledna asistenta, který shrnuje e-maily a připravuje nabídky. Na březnové faktuře od poskytovatele API se objevila částka 14 200 PLN netto namísto 2 100 PLN. Kód se nezměnil, nikdo nenasazoval nové funkce. Tento nárůst pramení ze tří polí, která jsou vidět v přehledu využití: vstupní tokeny rostou společně s historií konverzace, jeden požadavek po vyčerpání limitu opakuje smyčka a jeden API klíč obsluhuje pět týmů bez rozpočtů na jednotlivé projekty.
Faktura za API zahrnuje součet několika položek: vstupní tokeny (celá odeslaná historie), výstupní tokeny (vygenerovaný obsah), reasoning tokens, tool calling, structured output a také obraz či audio, pokud je model zpracovává. Mechanika konverzačního tahu je jednoduchá: cena za tah = součet vstupních tokenů z celé historie × sazba in plus vygenerované tokeny × sazba out. Z toho důvodu stojí konverzace s dokumentem o 20 tisících tokenů zanedbatelné částky, zatímco stejná konverzace po připojení celého vlákna dosáhne 200 tisíc tokenů a vyčerpá rozpočet ještě dříve, než model napíše první větu. Oficiální sazby OpenAI uvádí ceník, způsob počítání tokenů popisuje dokumentace.
Co lze zvládnout ještě tento týden
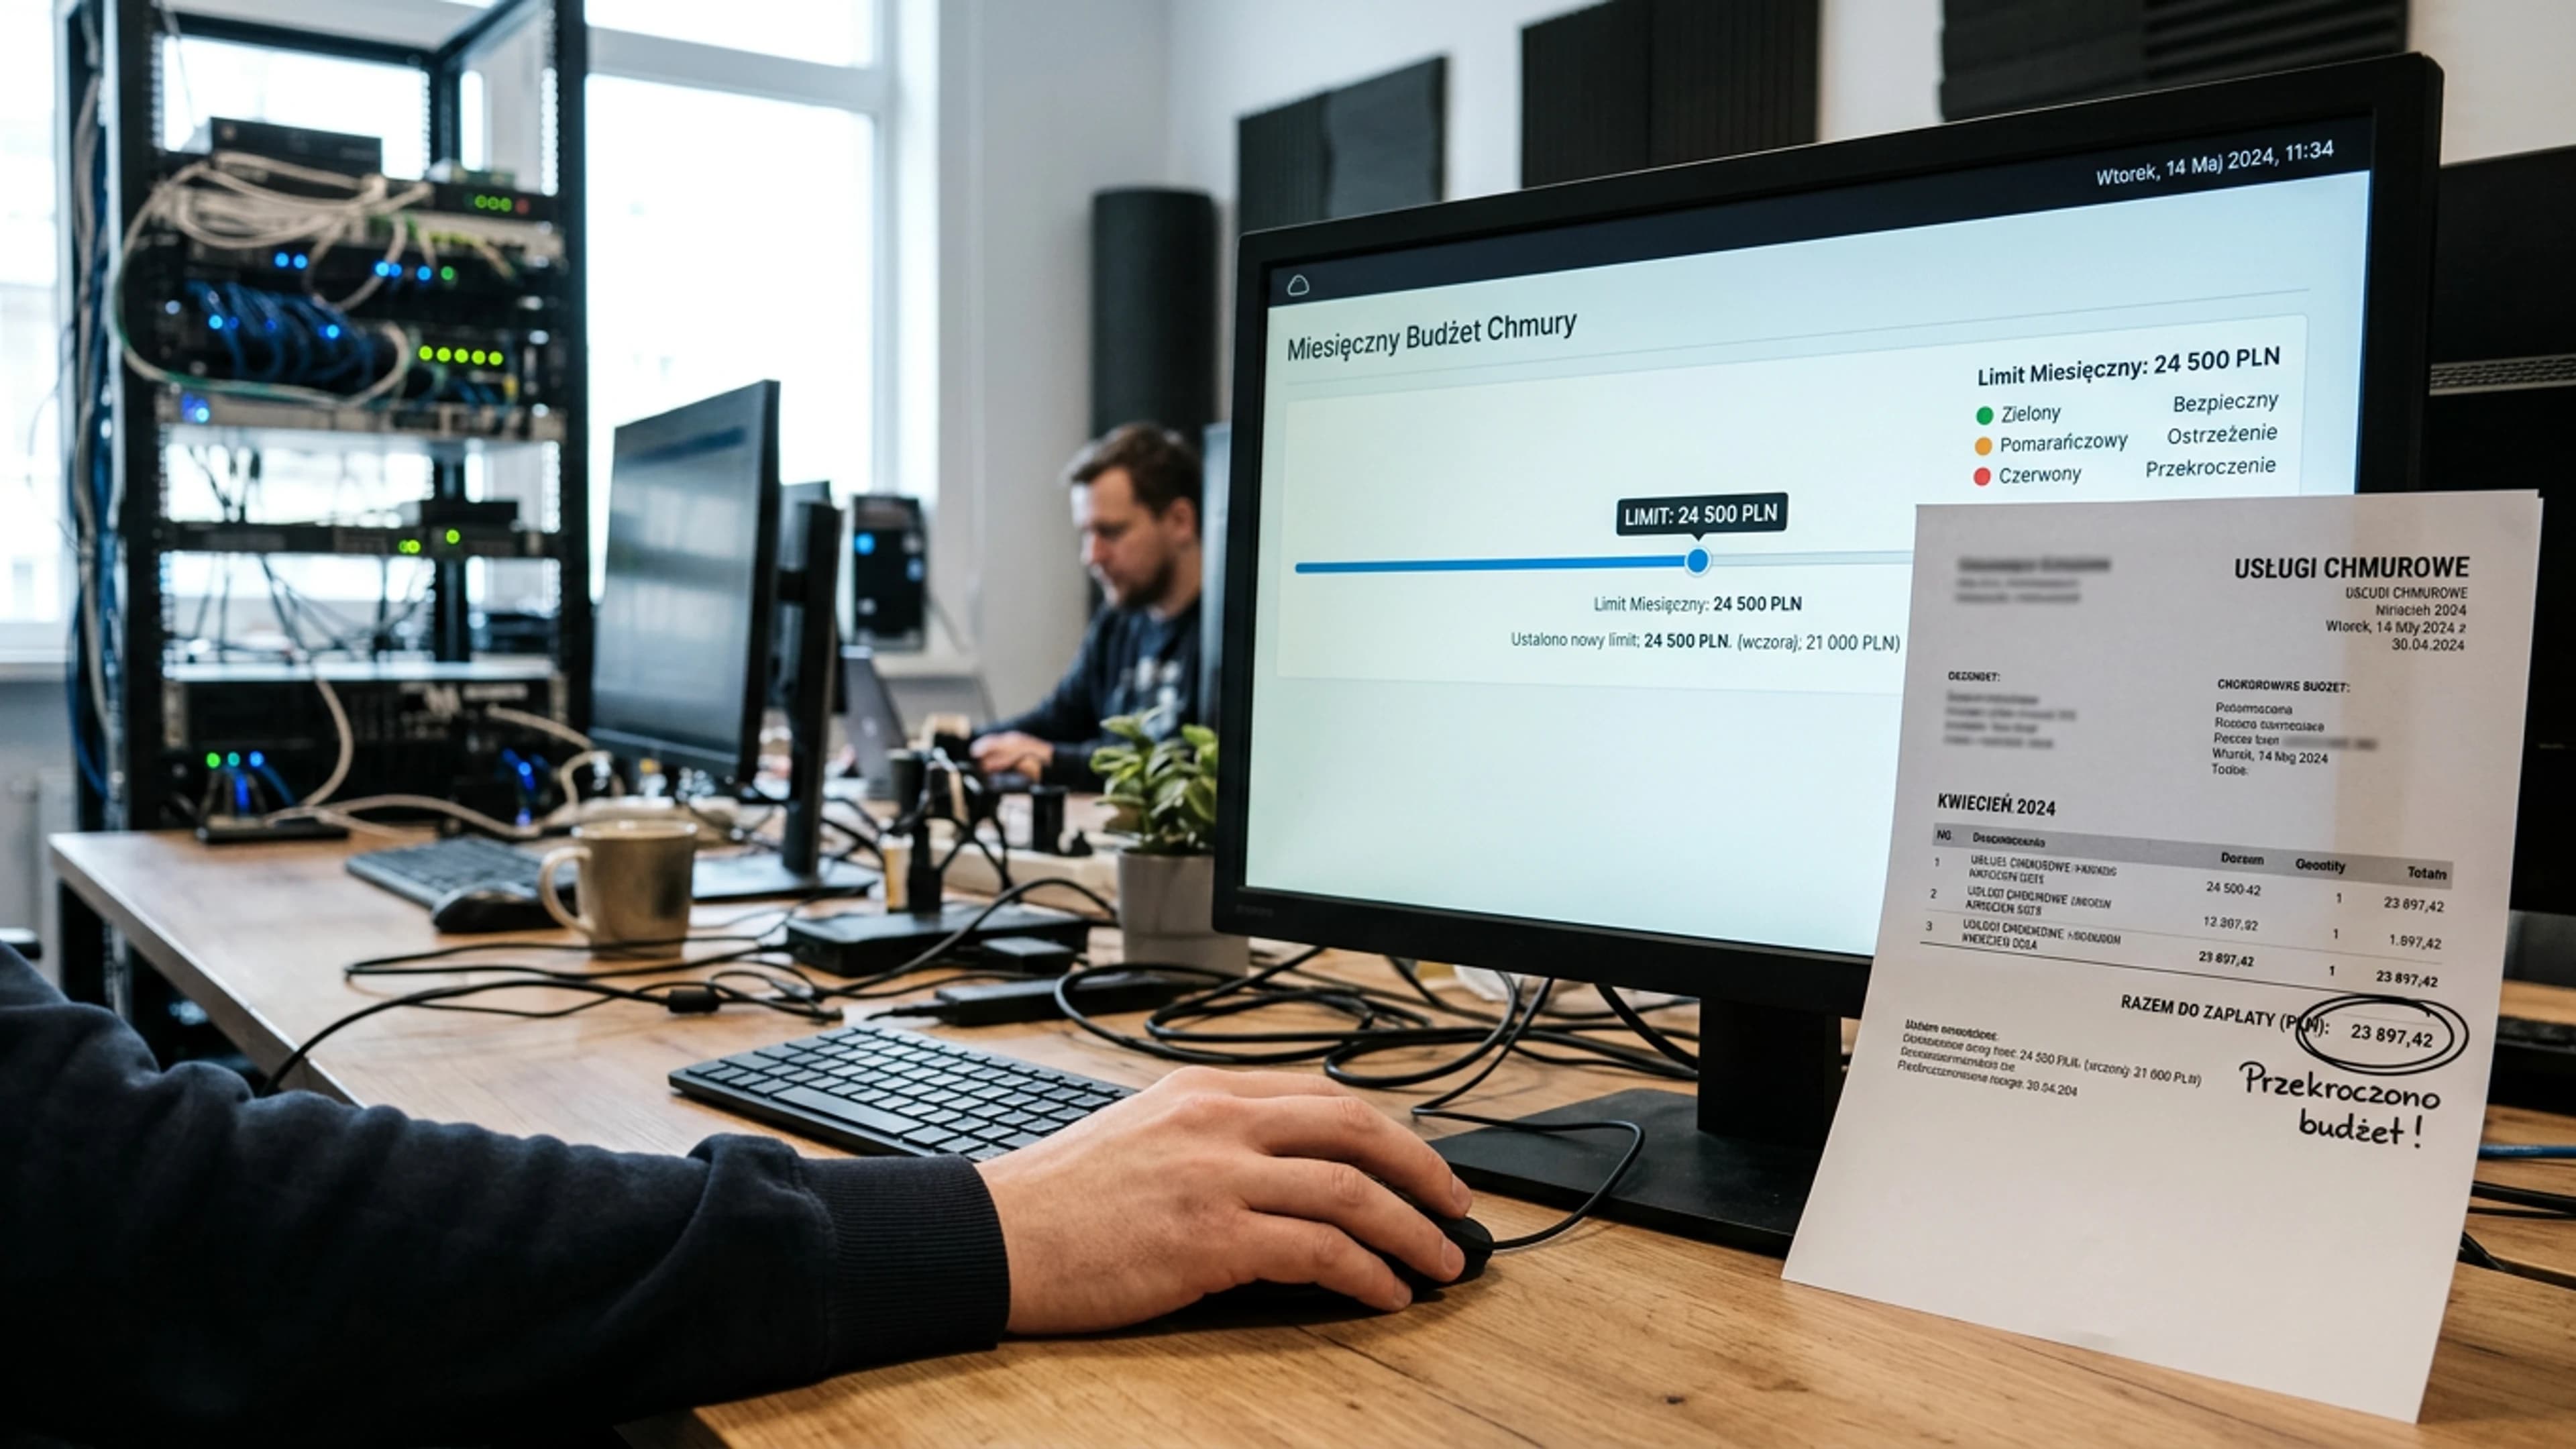
Krok 1: export usage do tabulky. Čas: 2 hodiny, řeší administrátor API nebo DevOps. Export z panelu poskytovatele filtrujte podle polí: model, api_key, project_id, cached_tokens, completion_tokens, requests. Sestavte kontingenční tabulku a zjistěte, který projekt a klíč generuje 80 % faktury. Krok 2: pevný limit a upozornění v konzoli. Čas: 30 minut, řeší vlastník fakturačního účtu. V OpenAI nastavte monthly budget, v Azure Cost Management rozpočet, v Google Cloud Billing upozornění, v AWS Budgets upozornění. Prahové hodnoty: 50 %, 80 %, 100 %. Při 100 % se musí API natvrdo zastavit. Krok 3: prompt caching u opakujících se kontextů. Čas: 2–4 hodiny, řeší aplikační inženýr. Stačí neposílat stejnou systémovou instrukci znovu a nastavit TTL mezipaměti tam, kde to dokumentace umožňuje. Odhadovaná úspora: 30–90 % nákladů na vstupní tokeny. Krok 4: menší model pro nízkorizikové trasy. Čas: 1 den, řeší produktový tým s vývojářem. Shrnutí e-mailů, kategorizace a první verze nabídek předejte modelům GPT-4o mini, Claude Haiku nebo Gemini Flash. Vyjednávání a analýzy smluv ponechte na větším modelu. Sazby pro modely Anthropic najdete v oficiálním ceníku. Krok 5: samostatné API klíče pro jednotlivé týmy. Čas: 2 hodiny, řeší IT Manager. Pro každý tým vytvořte nový klíč a limit výdajů. Nárůst z jedné smyčky retry se tak neztratí v celkovém vyúčtování.
Co nedělat hned na začátku
Prvním impulsem bývá nákup platformy pro monitoring výdajů na AI nebo LLM brány. Náklady na takovou implementaci obvykle činí 4 000–15 000 PLN a vyžádají si dva týdny integrace. Problémem tohoto týdne přitom nejčastěji bývá jediná smyčka opakovaných pokusů po kódu 429. Druhou chybou je plošný přechod na nejmenší model. U úkolů v polštině zvládají GPT-4o mini, Claude Haiku a Gemini Flash kategorizaci a shrnutí dobře, mohou však zkreslit data nebo částky v nabídce. Třetí chybou je jeden pevný limit pro celou firmu. V pátek v 16:40 zablokuje produkci, nikoli pouze experiment. Limity proto nastavujte pro jednotlivé klíče, projekty a týmy. Čtvrtou chybou je změna poskytovatele nebo vyjednávání hned v prvním týdnu. Bez reportu využití není o čem jednat. Pátou chybou je vypnutí Batch API a nočního zpracování. Sazba tam bývá o 50 % nižší a často představuje jedinou položku, která drží rozpočet.
Jak po dvou týdnech ověřit, že systém funguje
Po dvou týdnech spočítejte náklady na 1 milion vstupních a výstupních tokenů v projektu, který dříve generoval nejvyšší fakturu. V tabulce vydělte poplatek součtem vstupních a výstupních tokenů z pole usage. Referenční hodnota pro menší model v polštině podle kurzu z 24. 4. 2026 (1 USD = 3,78 PLN, zdroj NBP, částky net) činí 0,70–0,90 PLN za 1 milion tokenů vstupu a výstupu celkem. Pokud před změnou činila 2,40 PLN a po zapnutí mezipaměti a výměně modelu klesla na 1,10 PLN, úspora představuje 54 %. Hranice pro návrat: pokud náklady na 1 milion tokenů neklesly pod 1,20 PLN nebo podíl požadavků s chybou 429 Too Many Requests stále přesahuje 5 % celku, vraťte předchozí model a ověřte, zda mezipaměť skutečně zaznamenává zásahy.
Pokud nemáte čas na report a konfiguraci limitů, HEXART zajistí rychlý zásah: 3–5 pracovních dnů. Začínáme analýzou využití podle projektů a klíčů, následně nastavíme rozpočty, upozornění a pravidla mezipaměti. Výstupem je kontrolní tabulka pro pondělní přehled. Podrobnosti: https://hexart.pl/uslugi.
Zdrojové materiály
Materiály, ze kterých jsme čerpali při psaní. Výše uvedený text je náš, tyto stránky neodpovídají za jeho obsah ani jej neautorizovaly.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury
