Integrationer och data20:05
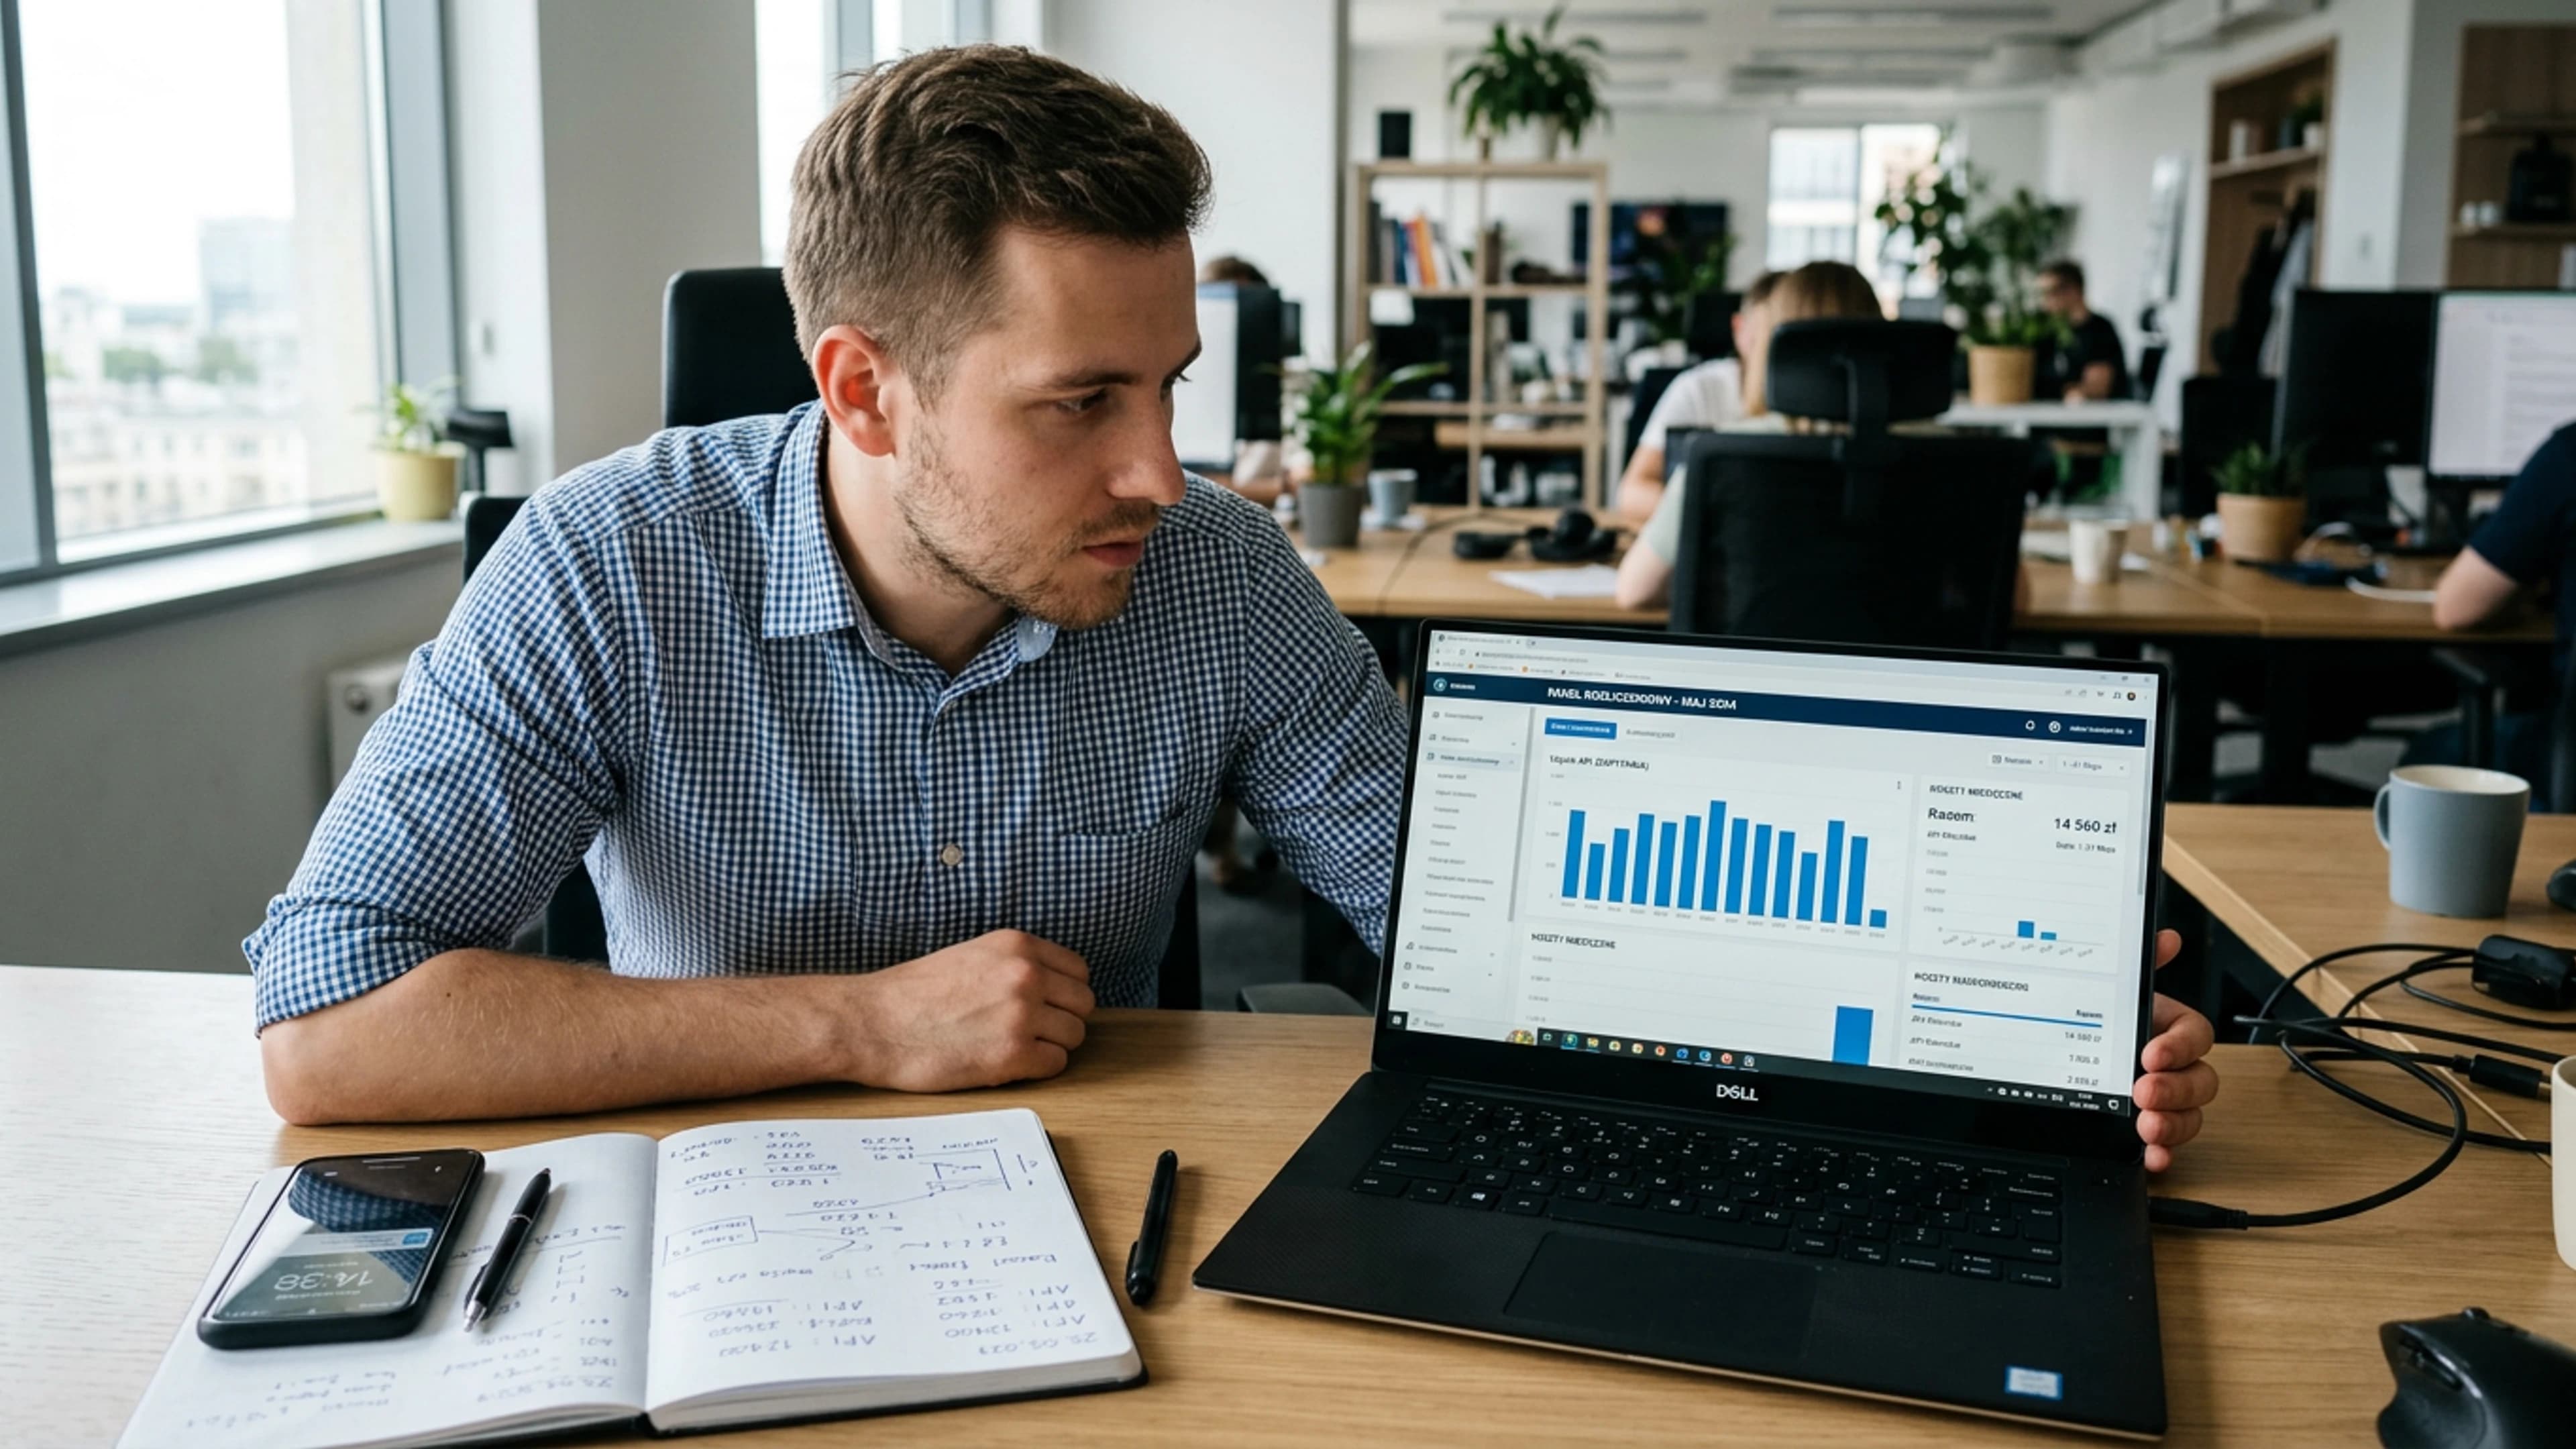
Varför API-fakturan landar på 14 200 PLN
Vi visar hur ni på en vecka spårar källan till API-kostnadstoppen i loggarna för usage, sätter hårda gränser och larm samt minskar kostnaderna med 35–60 procent utan nya verktyg.
Lyssna på en sammanfattning av artikeln
Syntetisk röst.Vi delar med oss av vad vi själva har testat under implementeringar: kostnadsfritt och utan antagandet att ert fall är identiskt. På ett handelsföretag med 70 anställda använder kundserviceteamet sedan januari en assistent som sammanfattar e-post och förbereder offerter. I marsfakturan från API-leverantören står det 14 200 PLN netto i stället för 2 100 PLN. Koden har inte ändrats, ingen har rullat ut nya funktioner. Denna ökning härrör från tre fält i användningspanelen: indatatoken växer i takt med konversationshistoriken, en förfrågan som nått gränsen upprepas i en loop och en enda API-nyckel hanterar fem team utan projektbudgetar.
På API-fakturan syns summan av flera delar: indatatoken (hela den skickade historiken), utdatatoken (genererat innehåll), resonemangstoken, verktygsanrop, strukturerad utdata samt bild eller ljud, om modellen behandlar dem. Mekaniken för en konversationsrunda är enkel: kostnad per runda = summan av indatatoken från hela historiken × indatataxa plus genererade token × utdatataxa. Därför kostar en konversation med ett dokument på 20 tusen token bara ören, medan samma konversation efter att hela tråden lagts till har 200 tusen token och förbrukar budgeten innan modellen hinner skriva den första meningen. Officiella priser för OpenAI finns i prislistan, och token samt hur de räknas beskrivs i dokumentationen.
Vad som kan göras den här veckan
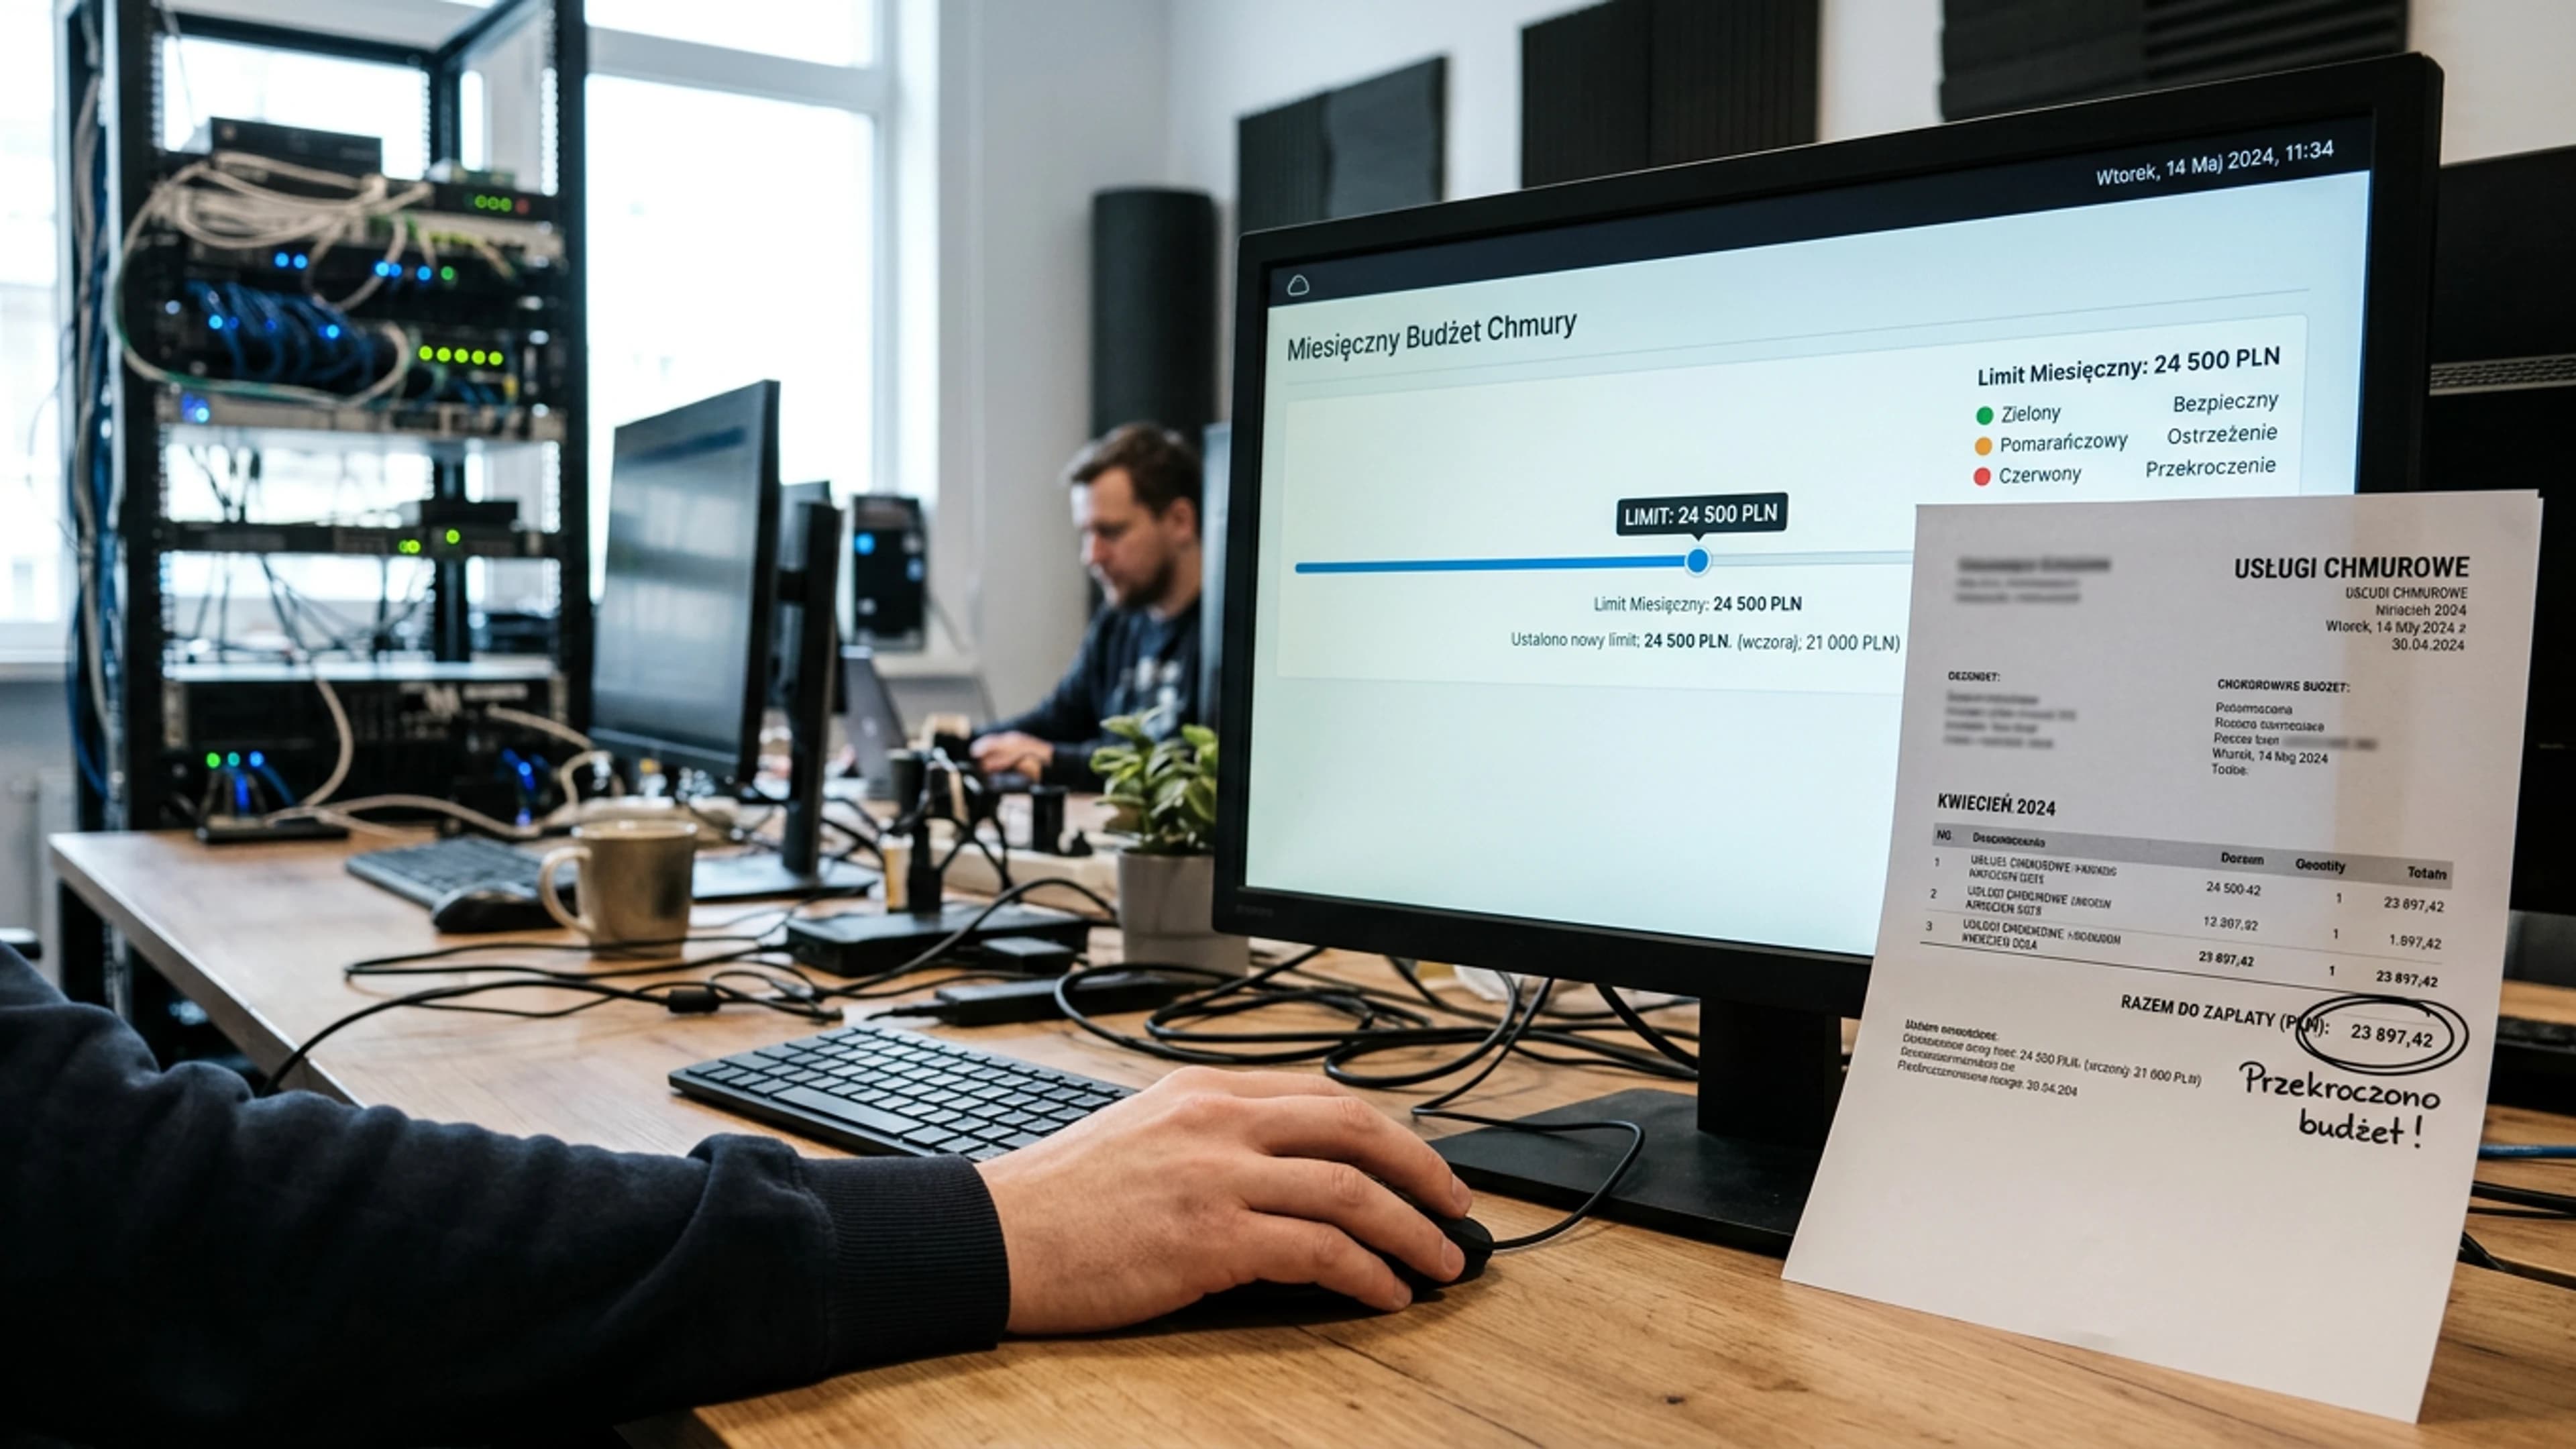
Steg 1: användningsrapport till kalkylark. Tidsåtgång: 2 timmar, utförs av API-administratör eller DevOps. Exportera från leverantörspanelen och filtrera på fälten: model, api_key, project_id, cached_tokens, completion_tokens, requests. Sammanställ i en pivottabell för att se vilket projekt och vilken nyckel som genererar 80 % av fakturan. Steg 2: hårda gränser och larm i konsolen. Tidsåtgång: 30 minuter, utförs av ägaren till faktureringskontot. I OpenAI sätts en månatlig budget, i Azure Cost Management en budget, i Google Cloud Billing ett larm, i AWS Budgets ett larm. Tröskelvärden: 50 %, 80 %, 100 %. Vid 100 % ska API:et stoppas helt. Steg 3: promptcaching vid återkommande kontexter. Tidsåtgång: 2–4 timmar, utförs av applikationsutvecklare. Skicka helt enkelt inte samma systeminstruktion på nytt och ställ in cache-TTL där dokumentationen tillåter det. Beräknad besparing: 30–90 % av utgifterna för indatatoken. Steg 4: mindre modell för lågriskflöden. Tidsåtgång: 1 dag, utförs av produktteamet tillsammans med utvecklare. Sammanfattning av e-post, kategorisering och preliminära offertutkast styrs till GPT-4o mini, Claude Haiku eller Gemini Flash, medan förhandlingsdialoger och avtalsanalyser stannar på den större modellen. Priser för Anthropic-modeller finns i den officiella prislistan. Steg 5: separata API-nycklar per team. Tidsåtgång: 2 timmar, utförs av IT-chefen. Skapa en ny nyckel och utgiftsgräns för varje team. På så sätt försvinner inte en kostnadsökning orsakad av en retry-loop i den totala fakturan.
Vad du inte ska göra direkt
Första instinkten är att köpa en plattform för AI-kostnadskontroll eller en LLM-gateway. Kostnaden för en sådan implementering är oftast 4 000–15 000 PLN och två veckors integration, medan veckans problem oftast visar sig vara en enda retry-loop efter statuskod 429. Det andra misstaget är att byta helt till den minsta modellen. För uppgifter på polska hanterar GPT-4o mini, Claude Haiku och Gemini Flash kategorisering och sammanfattningar väl, men de kan förvränga datum eller belopp i offerter. Det tredje misstaget är en enda hård gräns för hela företaget: en fredag kl. 16:40 blockerar det produktionen, inte bara experiment. Sätt istället gränser per nyckel, projekt och team. Det fjärde misstaget är leverantörsmigrering eller förhandlingar under första veckan; utan en usage-rapport finns inget att diskutera. Det femte misstaget är att stänga av Batch API och nattkörningar, där taxan ofta är 50 % lägre och det är ofta den enda faktorn som håller budgeten.
Så verifierar du effekten efter två veckor
Efter två veckor beräknar ni kostnaden per 1 miljon input- och output-tokens i det projekt som tidigare genererade störst faktura. Dela avgiften i kalkylarket med summan av input- och output-tokens från fältet usage. Riktvärdet för en mindre modell på polska, enligt växelkursen per 2026-04-24 (1 USD = 3,78 PLN, källa NBP, nettobelopp), är 0,70–0,90 PLN per 1 miljon tokens totalt för in- och utdata. Om nivån före ändringen var 2,40 PLN och sjönk till 1,10 PLN efter att cache aktiverats och modellen bytts ut, är besparingen 54 %. Tröskel för att backa: om kostnaden per 1 miljon tokens inte sjönk under 1,20 PLN eller om andelen förfrågningar med 429 Too Many Requests fortfarande överstiger 5 % totalt, återställ föregående modell och kontrollera att cachen faktiskt levererar träffar.
Om ni saknar tid för rapport och gränskonfiguration genomför HEXART detta som en kort punktinsats: 3–5 dagars arbete. Vi börjar med att kartlägga usage per projekt och nyckel, sätter sedan budgetar, larm och cacheregler. Ni får ett färdigt kontrollark för måndagen. Mer information: https://hexart.pl/uslugi.
Källmaterial
Material som vi har konsulterat under skrivandet. Texten ovan är vår egen; dessa webbplatser ansvarar inte för innehållet och har inte godkänt det.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury
