Integrationer og data20:05
Hvorfor API-fakturaen ender på 14.200 PLN
Vi viser, hvordan I på en uge sporer årsagen til API-fakturaens stigning i forbrugsloggene, opsætter faste grænser og alarmer samt reducerer omkostningerne med 35–60 procent uden nye værktøjer.
Lyt til artikelsammendraget
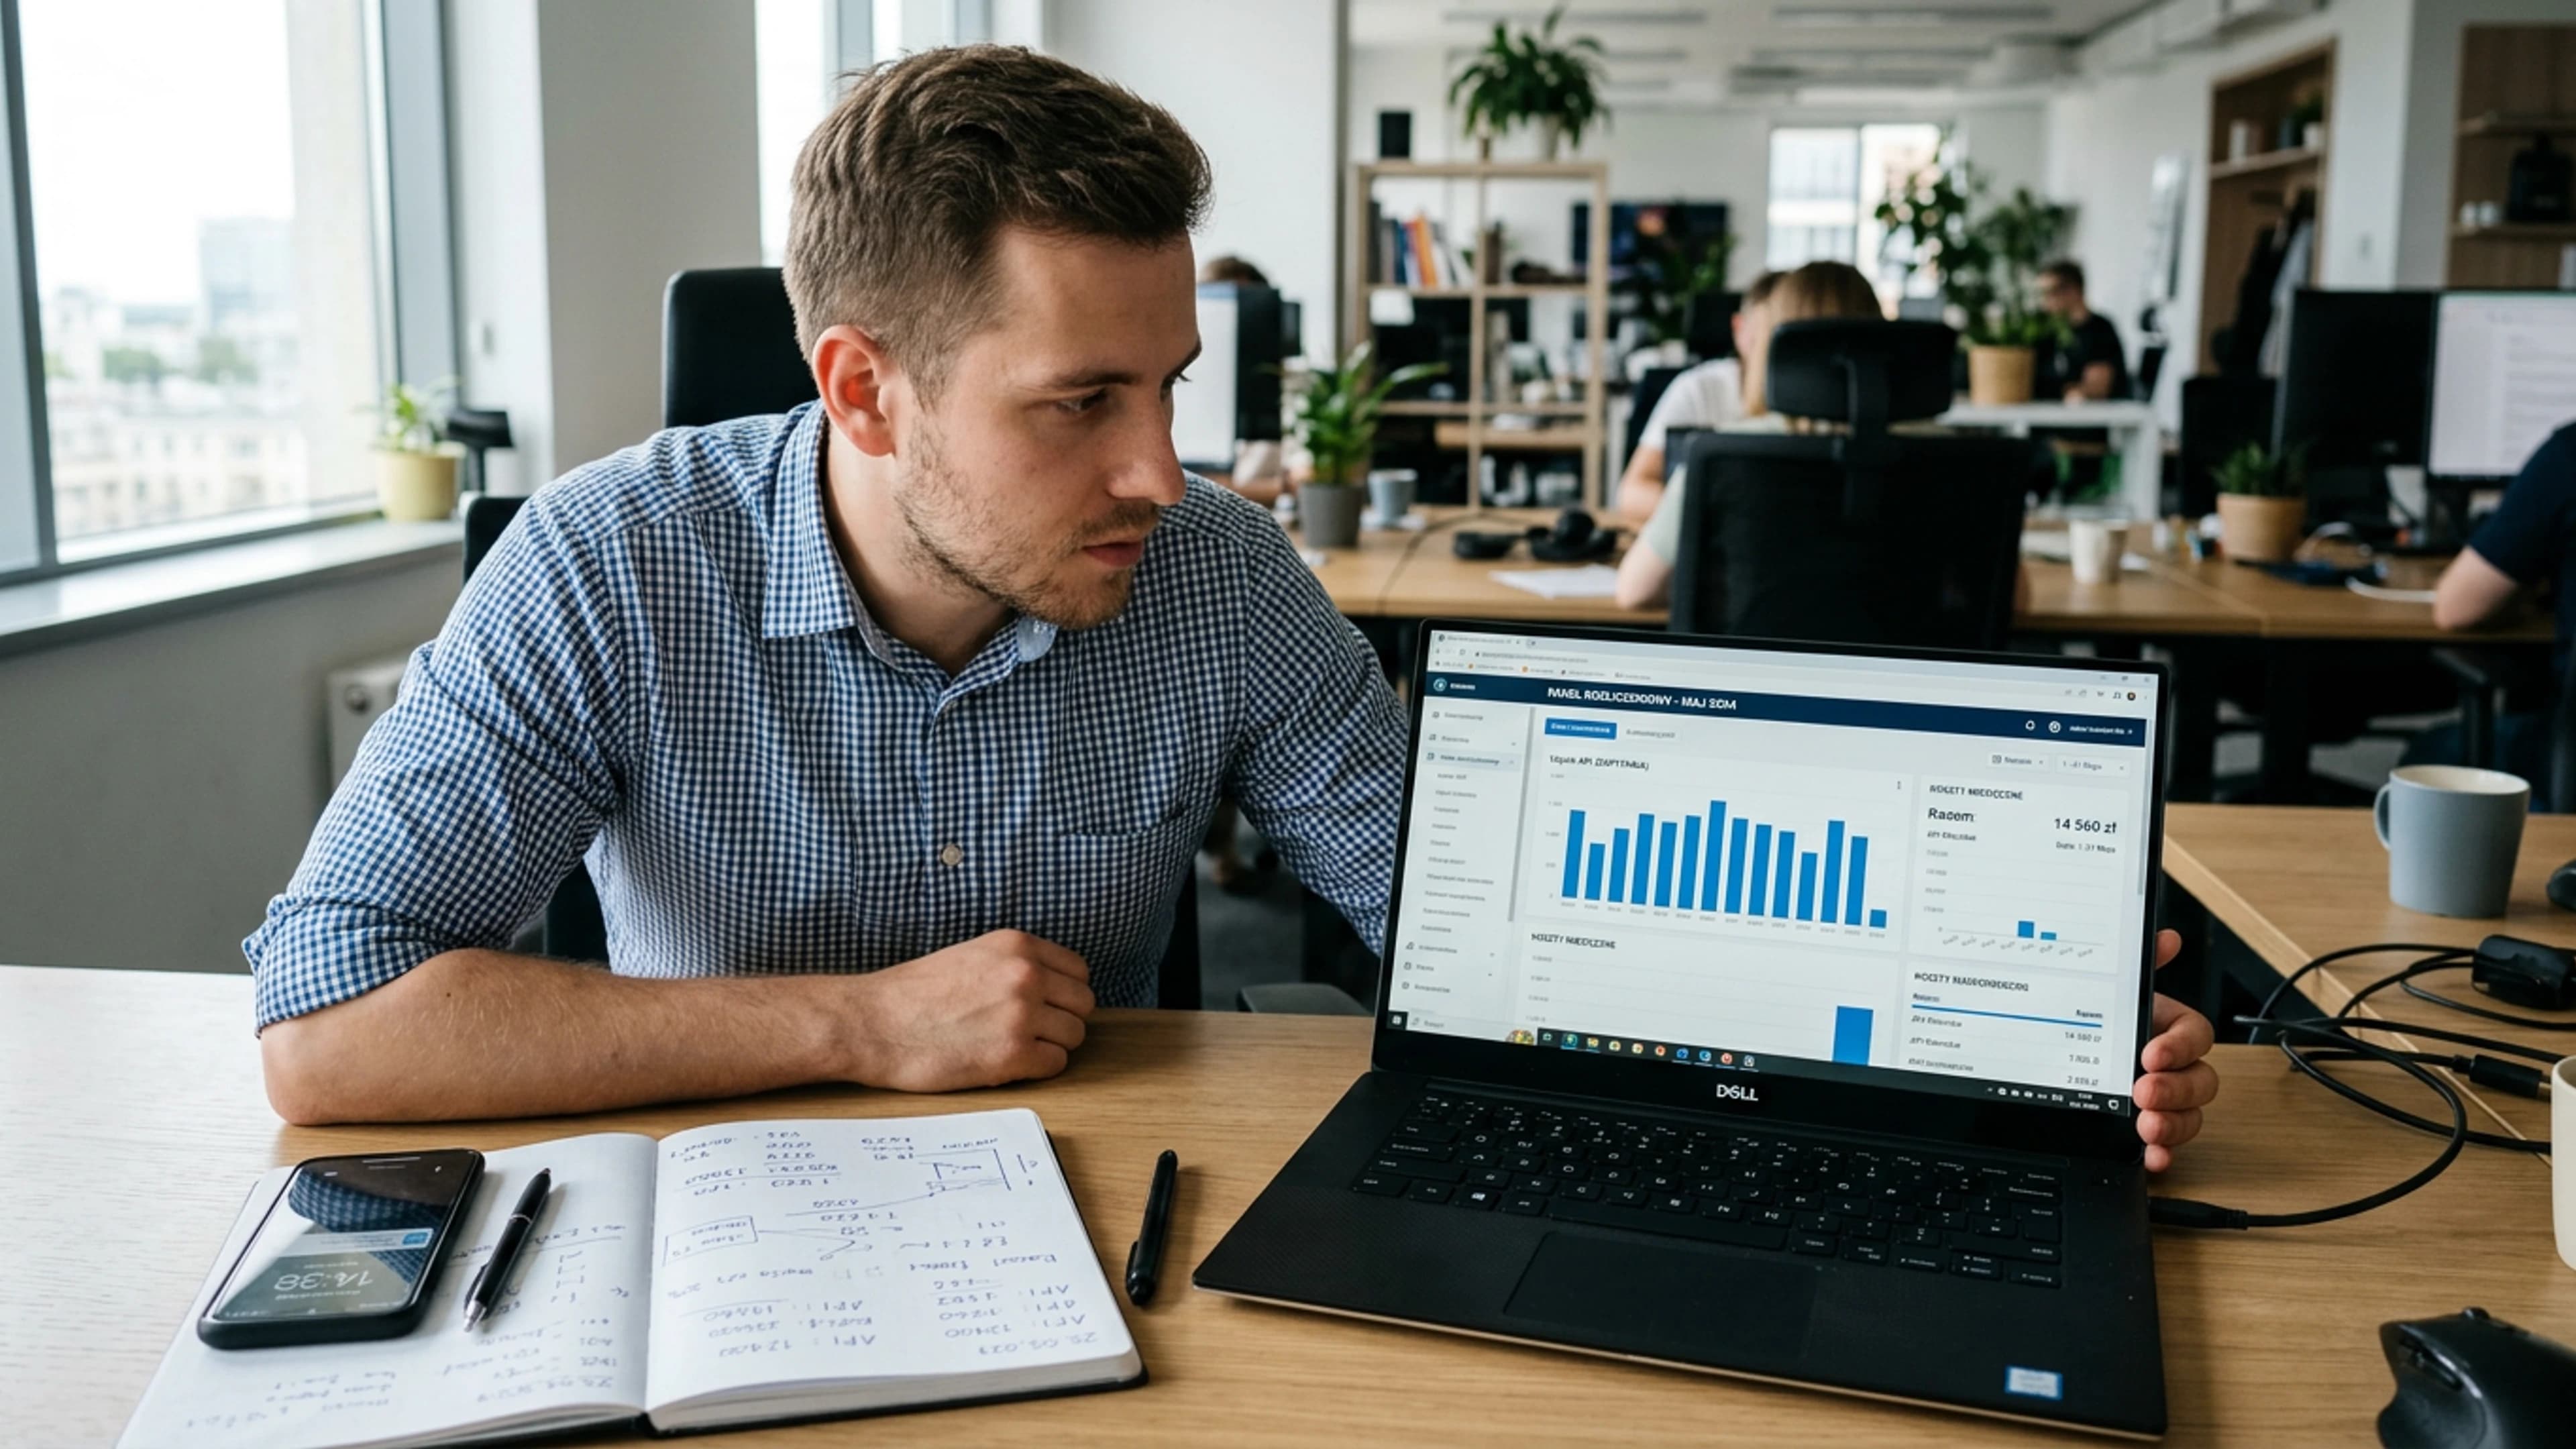
Syntetisk stemme.Vi deler det, vi selv har erfaret under implementeringer: Gratis og uden at antage, at jeres situation er identisk. I en handelsvirksomhed med 70 medarbejdere har kundeserviceteamet siden januar brugt en assistent, der opsummerer e-mails og udarbejder tilbud. På martsfakturaen fra API-udbyderen står der 14.200 PLN netto i stedet for 2.100 PLN. Koden er uændret, og ingen har udrullet nye funktioner. Stigningen skyldes tre felter i forbrugspanelet: Input-tokens stiger i takt med samtalehistorikken, forespørgsler efter overskredet grænse gentages i et loop, og en enkelt API-nøgle bruges af fem teams uden projektbudgetter.
En API-faktura er summen af flere elementer: input-tokens (hele den afsendte historik), output-tokens (det genererede indhold), reasoning tokens, tool calling, structured output samt billeder eller lyd, hvis modellen behandler dem. Samtalerundens mekanik er enkel: Pris per runde = summen af input-tokens fra hele historikken × takst for input plus genererede tokens × takst for output. Derfor koster en samtale om et dokument på 20.000 tokens næsten ingenting, mens den samme samtale med hele tråden inkluderet når 200.000 tokens og opbruger budgettet, før modellen skriver sin første sætning. De officielle takster for OpenAI findes i prislisten, og tokens samt optælling er beskrevet i dokumentationen.
Hvad der kan gøres i denne uge
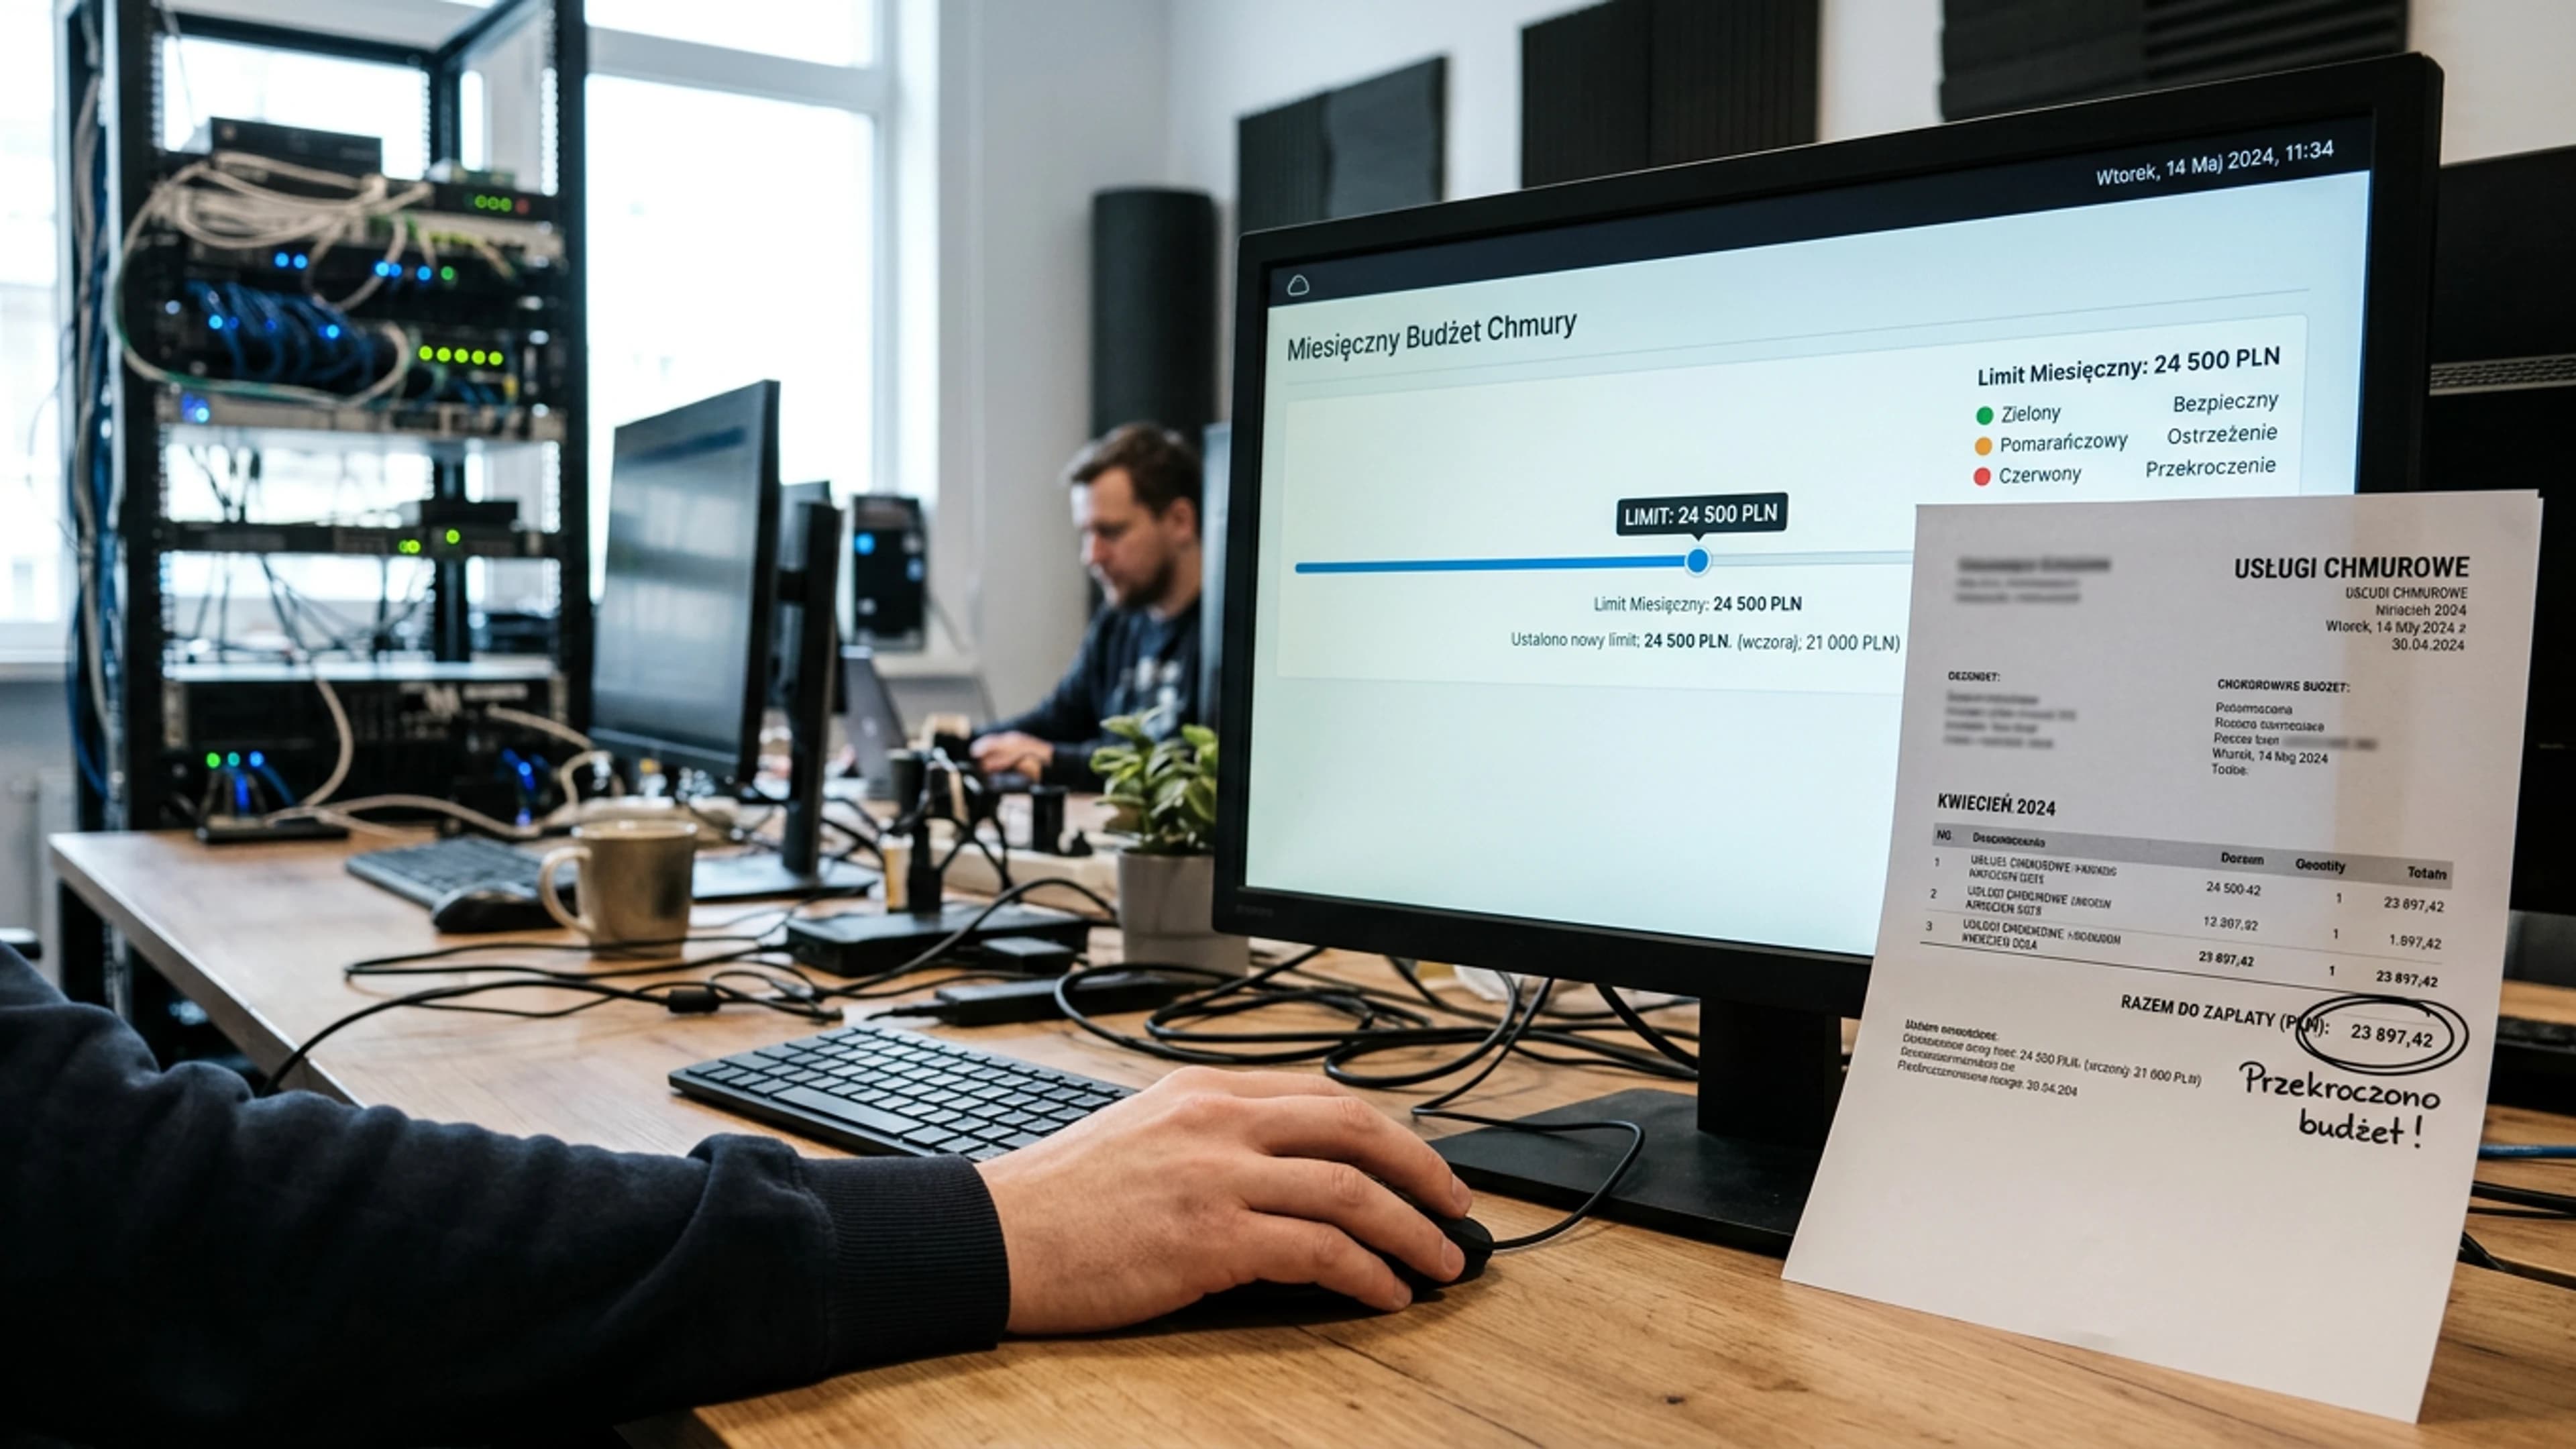
Trin 1: Forbrugsrapport til regneark. Tid: 2 timer, udføres af API-administrator eller DevOps. Eksport fra udbyderens panel filtreres på felterne: model, api_key, project_id, cached_tokens, completion_tokens, requests. Opret en pivottabel for at identificere, hvilket projekt og hvilken nøgle der tegner sig for 80% af fakturaen. Trin 2: Fast grænse og advarsler i konsollen. Tid: 30 minutter, udføres af billing-kontoens ejer. Opsæt et månedligt budget i OpenAI, budget i Azure Cost Management, advarsel i Google Cloud Billing og advarsel i AWS Budgets. Tærskler: 50%, 80%, 100%. Ved 100% skal API'et stoppe helt. Trin 3: Prompt caching ved gentaget kontekst. Tid: 2–4 timer, udføres af applikationsingeniøren. Undgå at sende den samme systeminstruktion igen, og konfigurer cache-TTL i overensstemmelse med dokumentationen. Forventet besparelse: 30–90% af udgifterne til input-tokens. Trin 4: Mindre model til lavrisikoopgaver. Tid: 1 dag, udføres af produktteamet og en udvikler. Opsummering af e-mails, kategorisering og udkast til tilbud flyttes til GPT-4o mini, Claude Haiku eller Gemini Flash, mens forhandlinger og kontraktanalyser forbliver på den store model. Takster for Anthropic-modeller findes i den officielle prisliste. Trin 5: Separate API-nøgler per team. Tid: 2 timer, udføres af IT-chefen. Opret en ny nøgle og et forbrugsloft for hvert team. Dermed drukner en stigning fra et enkelt retry-loop ikke i den samlede regning.
Hvad man ikke skal gøre med det samme
Den første indskydelse er at købe en platform til overvågning af AI-omkostninger eller en LLM-gateway. En sådan implementering koster typisk 4.000–15.000 PLN og tager to ugers integration, mens ugens reelle problem oftest viser sig at være en enkelt retry-løkke efter en 429-fejlkode. Den anden fejl er at skifte globalt til den mindste model. Til opgaver på polsk klarer GPT-4o mini, Claude Haiku og Gemini Flash kategorisering og resuméer godt, men de kan fordreje datoer eller beløb i et tilbud. Den tredje fejl er én hård grænse for hele virksomheden: den blokerer produktionen fredag kl. 16:40 i stedet for kun at stoppe eksperimenter. Sæt i stedet grænser per nøgle, projekt og team. Den fjerde fejl er leverandørmigrering eller forhandlinger i den første uge; uden en forbrugsrapport er der intet grundlag at forhandle ud fra. Den femte fejl er at fravælge Batch API og natkørsel, hvor taksten ofte er 50% lavere, hvilket ofte er det eneste, der holder budgettet.
Sådan kontrollerer du efter to uger, at det virker
Efter to uger beregner I udgiften per 1 mio. input- og output-tokens i det projekt, der tidligere gav den største faktura. I regnearket dividerer I gebyret med summen af input- og output-tokens fra forbrugsfeltet. Referenceværdien for en mindre model på polsk ved kursen pr. 24.04.2026 (1 USD = 3,78 PLN, kilde NBP, nettobeløb) er 0,70–0,90 PLN for 1 mio. tokens samlet input og output. Lå udgiften før ændringen på 2,40 PLN og faldt til 1,10 PLN efter aktivering af cache og modelskift, er besparelsen 54%. Grænse for tilbagerulning: Hvis udgiften per 1 mio. tokens ikke faldt til under 1,20 PLN, eller andelen af requests med 429 Too Many Requests fortsat overstiger 5% af det samlede antal, genaktiver da den tidligere model og kontrollér, om cachen reelt genererer hits.
Mangler I tid til rapporten og opsætning af grænser, løser HEXART opgaven som et kort forløb: 3–5 dages arbejde. Vi starter med at udtrække forbrug per projekt og nøgle, hvorefter vi opsætter budgetter, alarmer og cacheregler. Resultatet er et kontrolark klar til mandag. Detaljer: https://hexart.pl/uslugi.
Kildemateriale
Materialer, vi har rådført os med under udarbejdelsen. Ovenstående tekst er vores egen; disse websteder er ikke ansvarlige for indholdet og har ikke godkendt det.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury
