Posłuchaj skrótu artykułu (Audio)Lektor wygenerowany przez AI
Dzielimy się tym, co sami sprawdziliśmy przy wdrożeniach: bezpłatnie i bez założenia, że Twój przypadek wygląda identycznie. W firmie handlowej na 70 osób zespół obsługi klienta od stycznia używa asystenta, który streszcza maile i przygotowuje oferty. W marcowej fakturze od dostawcy API widnieje 14 200 zł netto zamiast 2 100 zł. Kod się nie zmienił, nikt nie wdrażał nowych funkcji. Ten skok bierze się z trzech pól, które widać w panelu usage: tokeny wejściowe rosną razem z historią rozmowy, jedno zapytanie po limicie jest ponawiane przez pętlę, a jeden klucz API obsługuje pięć zespołów bez budżetów per projekt.
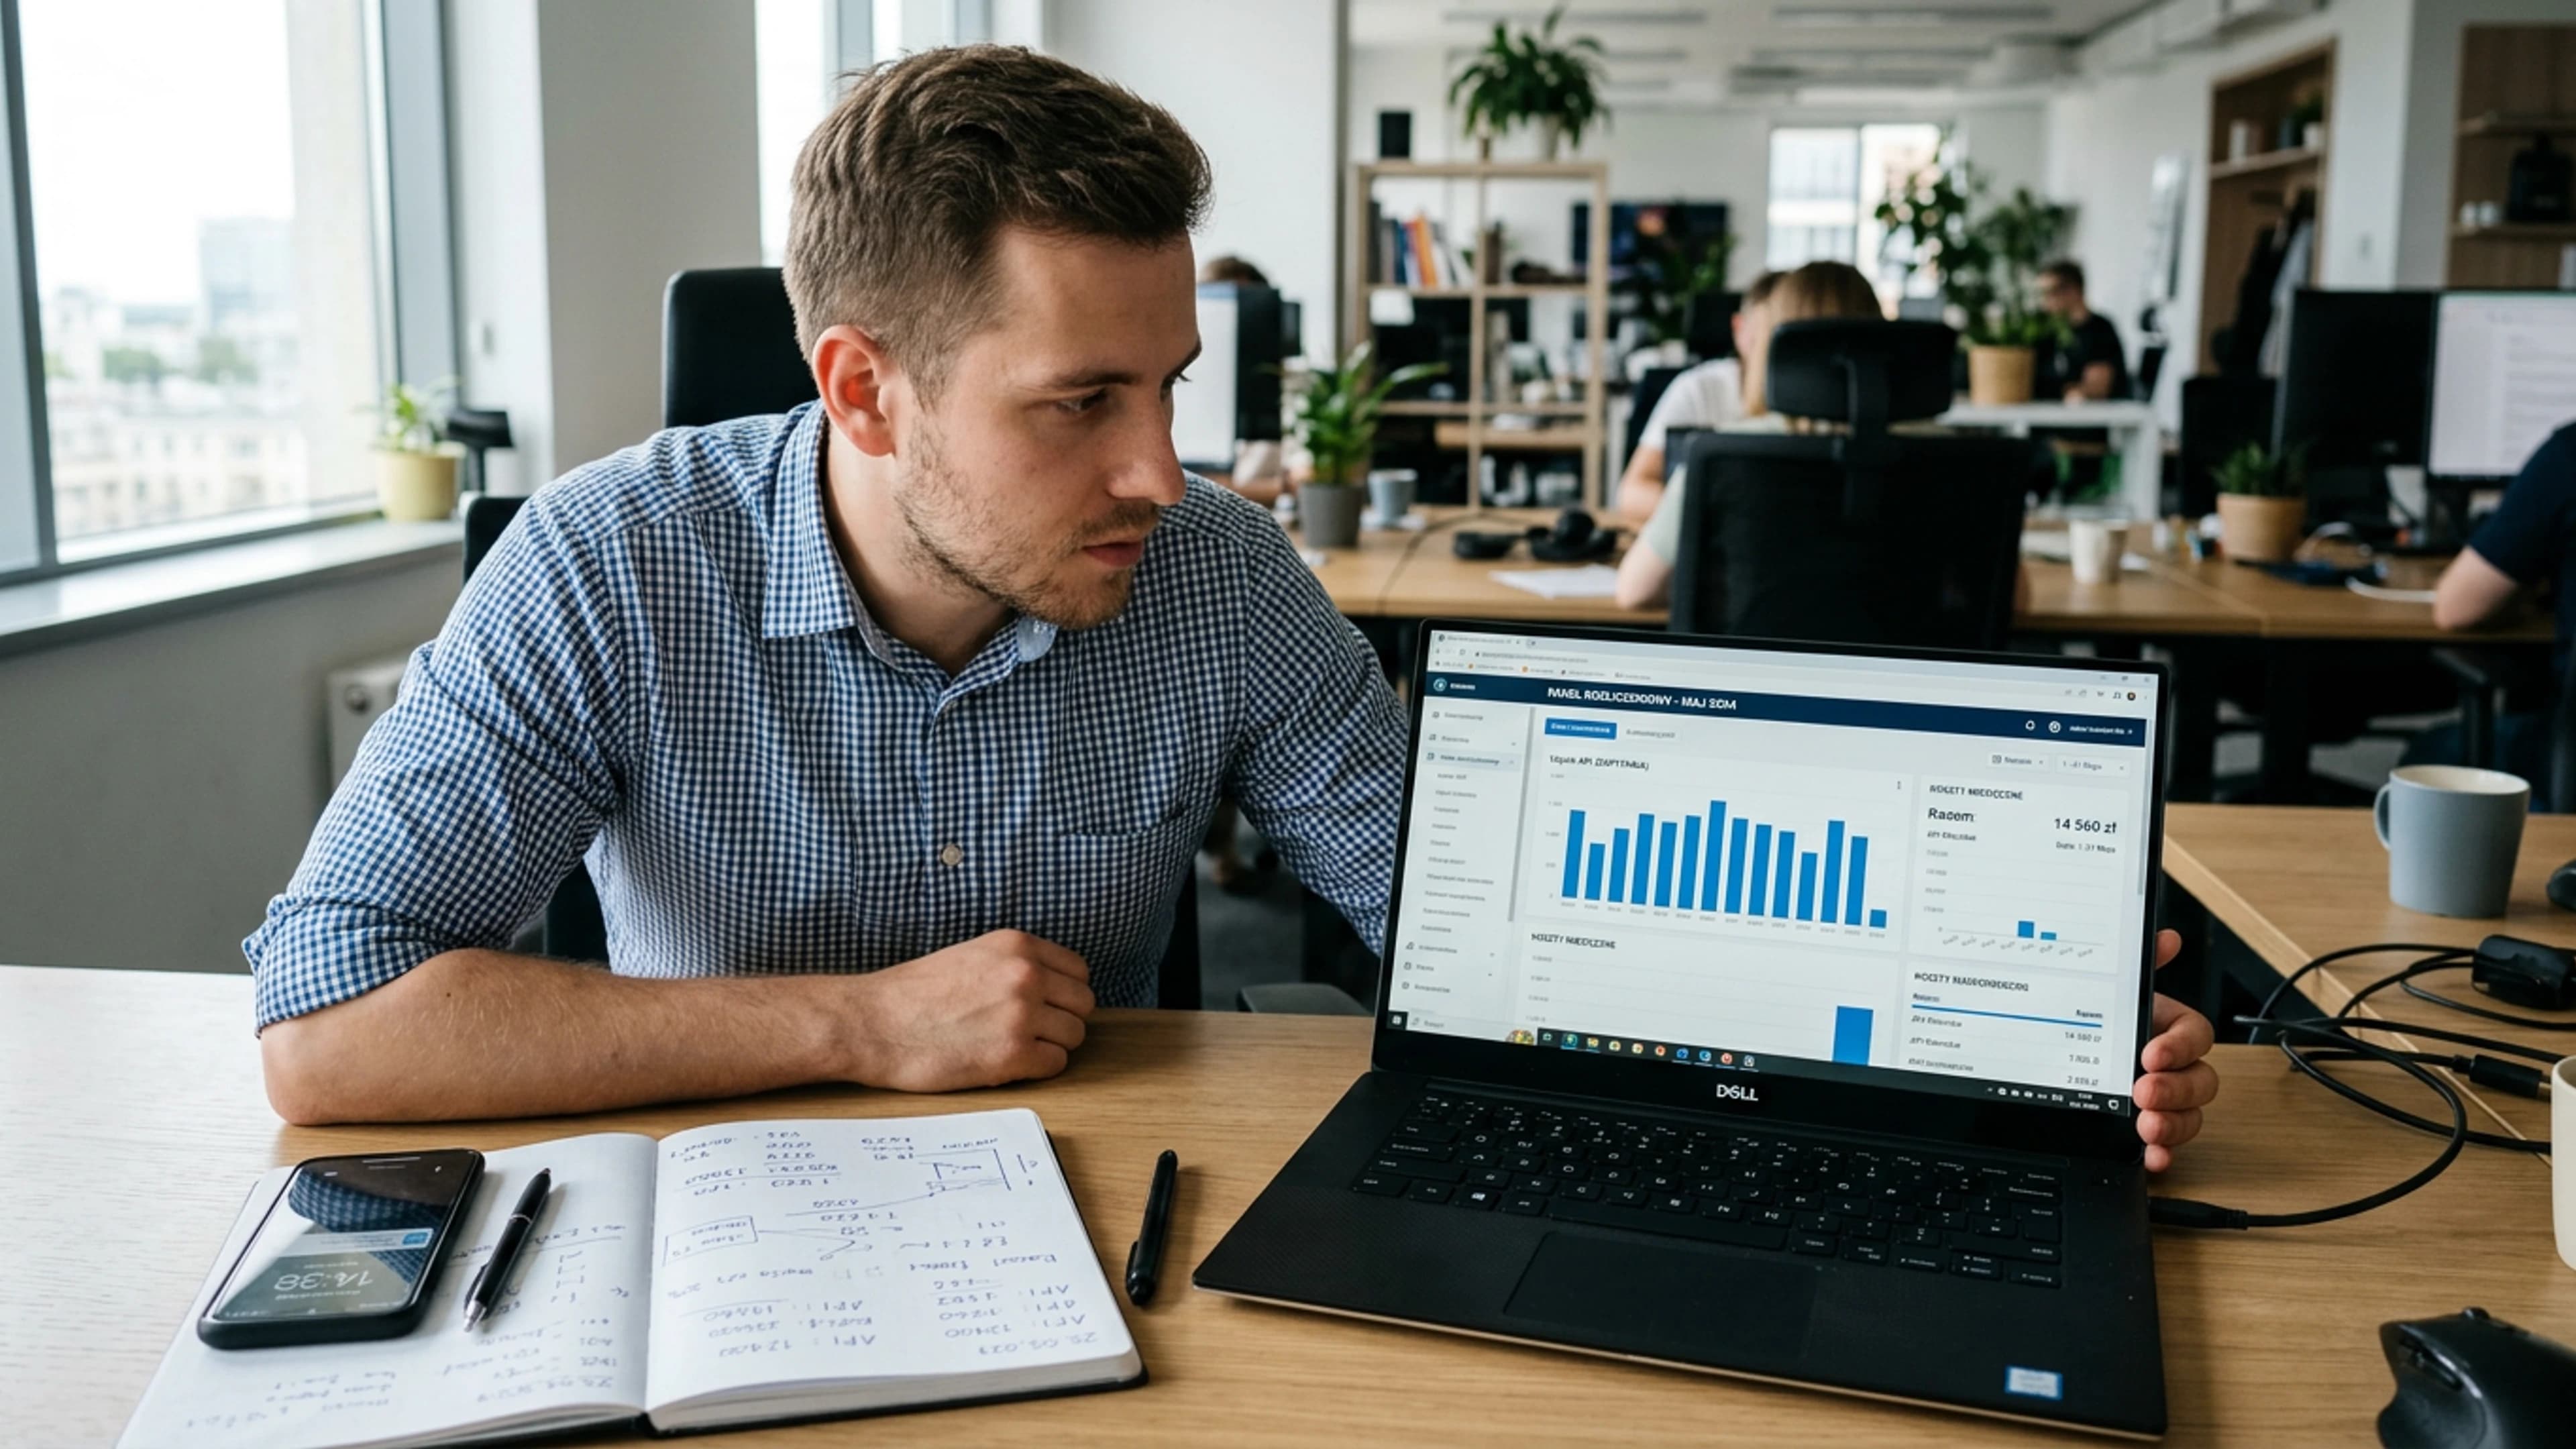
Na fakturze za API widnieje suma kilku rzeczy: tokeny wejściowe (cała wysłana historia), tokeny wyjściowe (wygenerowana treść), reasoning tokens, tool calling, structured output oraz obrazy albo audio, jeśli model je przetwarza. Mechanika tury rozmowy jest prosta: opłata tury = suma tokenów wejściowych z całej historii × stawka in plus wygenerowane tokeny × stawka out. Dlatego rozmowa z dokumentem o 20 tys. tokenów to grosze, a ta sama rozmowa po dołożeniu całego wątku ma 200 tys. tokenów i wyczerpuje budżet, zanim model napisze pierwsze zdanie. Oficjalne stawki OpenAI są w cenniku, a tokeny i ich zliczanie opisuje dokumentacja.
Co da się zrobić w tym tygodniu
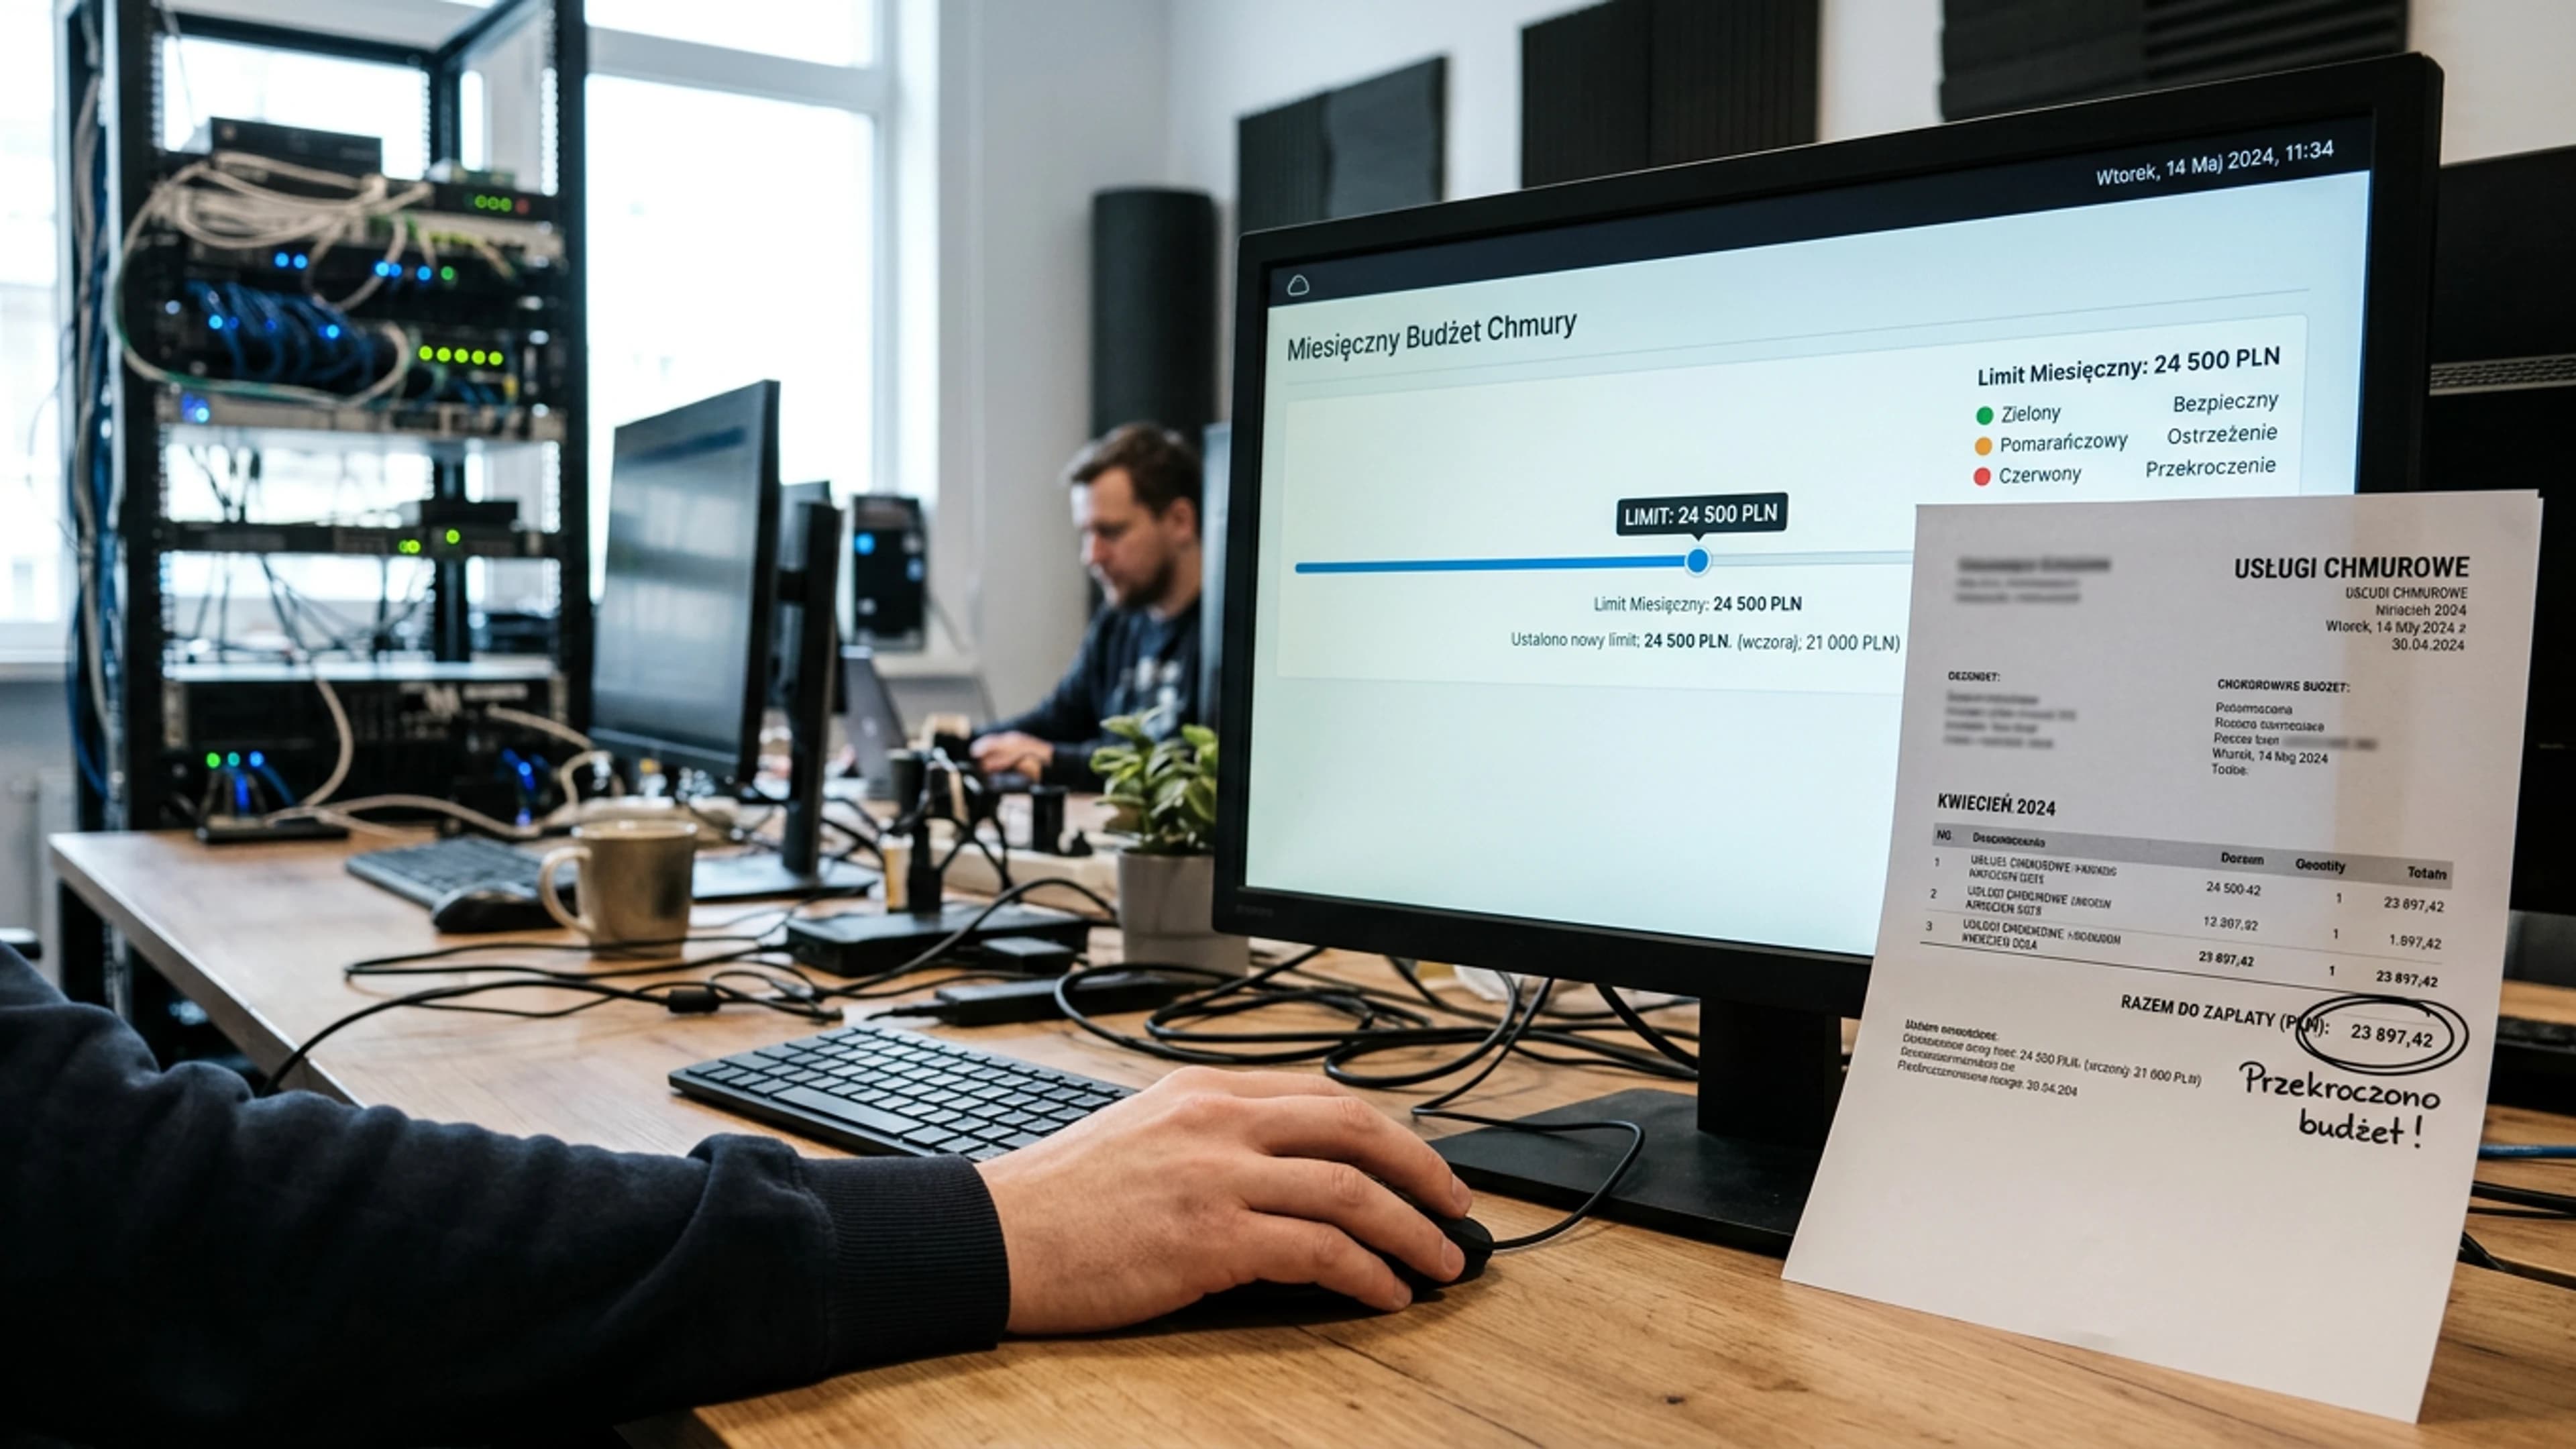
Ruch 1 — raport usage do arkusza. Czas: 2 godziny, robi administrator API albo DevOps. Eksport z panelu dostawcy filtruje po polach: model, api_key, project_id, cached_tokens, completion_tokens, requests. Układa w tabelę przestawną, żeby zobaczyć, który projekt i klucz generuje 80% faktury. Ruch 2 — twardy limit i alerty w konsoli. Czas: 30 minut, robi właściciel konta billingowego. W OpenAI ustawia się monthly budget, w Azure Cost Management budżet, w Google Cloud Billing alert, w AWS Budgets alert. Progi: 50%, 80%, 100%. Przy 100% API powinno twardo stanąć. Ruch 3 — prompt caching przy powtarzalnych kontekstach. Czas: 2–4 godziny, robi inżynier aplikacji. Wystarczy nie wysyłać tej samej instrukcji systemowej od nowa i ustawić cache TTL tam, gdzie przewiduje to dokumentacja. Szacunkowa oszczędność: 30–90% wydatku na wejściowe tokeny. Ruch 4 — mniejszy model w trasach niskiego ryzyka. Czas: 1 dzień, robi zespół produktowy z programistą. Streszczanie maili, kategoryzacja, wstępne wersje ofert idą na GPT-4o mini, Claude Haiku lub Gemini Flash, a rozmowy negocjacyjne i analizy umów zostają na większym modelu. Stawki dla modeli Anthropic są w oficjalnym cenniku. Ruch 5 — osobne klucze API per zespół. Czas: 2 godziny, robi IT Manager. Dla każdego zespołu nowy klucz i limit wydatków. Dzięki temu skok z jednej pętli retry nie znika w ogólnym rachunku.
Czego nie robić od razu
Pierwszy odruch to kupno platformy do monitoringu wydatków na AI albo bramki LLM. Wydatek takiego wdrożenia to zwykle 4 000–15 000 złotych i dwa tygodnie integracji, a problem w tym tygodniu najczęściej okazuje się jedną pętlą retry po kodzie 429. Drugi błąd to globalne zejście na najmniejszy model. Przy zadaniach po polsku GPT-4o mini, Claude Haiku i Gemini Flash dobrze radzą sobie z kategoryzacją i streszczeniami, ale potrafią przekręcić daty albo kwoty w ofercie. Trzeci błąd to jeden twardy limit na całą firmę — w piątek o 16:40 zablokuje produkcję, a nie tylko eksperyment. Zamiast tego limity zakłada się per klucz, projekt i zespół. Czwarty błąd to migracja dostawcy albo negocjacje w pierwszym tygodniu; bez raportu usage nie ma o czym rozmawiać. Piąty błąd to wyłączenie Batch API i przetwarzania nocnego, bo tam stawka bywa o 50% niższa i to często jedyna rzecz, która trzyma budżet.
Jak sprawdzić po dwóch tygodniach, że działa
Po dwóch tygodniach liczysz wydatek na 1 mln tokenów wejściowych i wyjściowych w projekcie, który wcześniej generował największą fakturę. W arkuszu dzielisz opłatę przez sumę tokenów wejściowych i wyjściowych z pola usage. Wartość odniesienia dla mniejszego modelu po polsku, przy kursie z 24.04.2026 (1 USD = 3,78 zł, źródło NBP, kwoty netto), to 0,70–0,90 zł za 1 mln tokenów wejścia i wyjścia łącznie. Jeżeli przed zmianą było 2,40 zł, a po włączeniu cache i podmianie modelu spadło do 1,10 zł, oszczędność wynosi 54%. Próg do wycofania: jeśli wydatek na 1 mln tokenów nie spadł poniżej 1,20 zł albo udział requestów z 429 Too Many Requests nadal przekracza 5% ogółu, przywróć poprzedni model i sprawdź, czy cache faktycznie zwraca trafienia.
Jeśli nie ma u was czasu na raport i konfigurację limitów, HEXART robi to jako krótkie wejście: 3–5 dni pracy, zaczynamy od wyciągnięcia usage per projekt i klucz, potem ustawiamy budżety, alerty i reguły cache. Zostaje po tym arkusz kontrolny na poniedziałek. Szczegóły: https://hexart.pl/uslugi.
Materiały, do których zaglądaliśmy przy pisaniu. Tekst powyżej jest nasz; te strony nie odpowiadają za jego treść ani jej nie autoryzowały.
- Opodatkowanie przychodów z działalności gospodarczej związanej z rozwojem modeli AI w formie ryczałtu 8,5% - Interpretacja indywidualna z dnia 29 kwietnia 2025 r., Dyrektor Krajowej Informacji Skarbowej, sygn. 0115-KDST2-2.4011.130.2025.2.AP - INFORLEX Freemium
- AI w księgowości zaczyna się od faktury