Posłuchaj skrótu artykułu (Audio)Lektor wygenerowany przez AI
Materiał poradnikowy, pisany z perspektywy wykonawcy. Opisuje typowe rozwiązania, nie rozstrzyga jednostkowego przypadku. Pierwszy test jest prosty: poproś o dokładną nazwę modelu, wersję i endpoint. Jeśli dostawca mówi o „własnym modelu" bez dokumentacji, to zwykle nakładka na cudze API. Drugi sygnał to cena — oferty na to samo zadanie różnią się 3 do 10 razy, bo część firm tylko odsprzedaje dostęp do modelu. Mediana marży integratorskiej przy prawdziwej integracji wynosi 18–35% kosztu modelu. Powyżej 50–100% bez własnych komponentów inżynierskich to już sygnał nakładki. Od 2 sierpnia 2025 r. modele ogólnego przeznaczenia mają własne obowiązki, a od 2 sierpnia 2026 r. stosuje się większość przepisów AI Act.
Skąd to się bierze
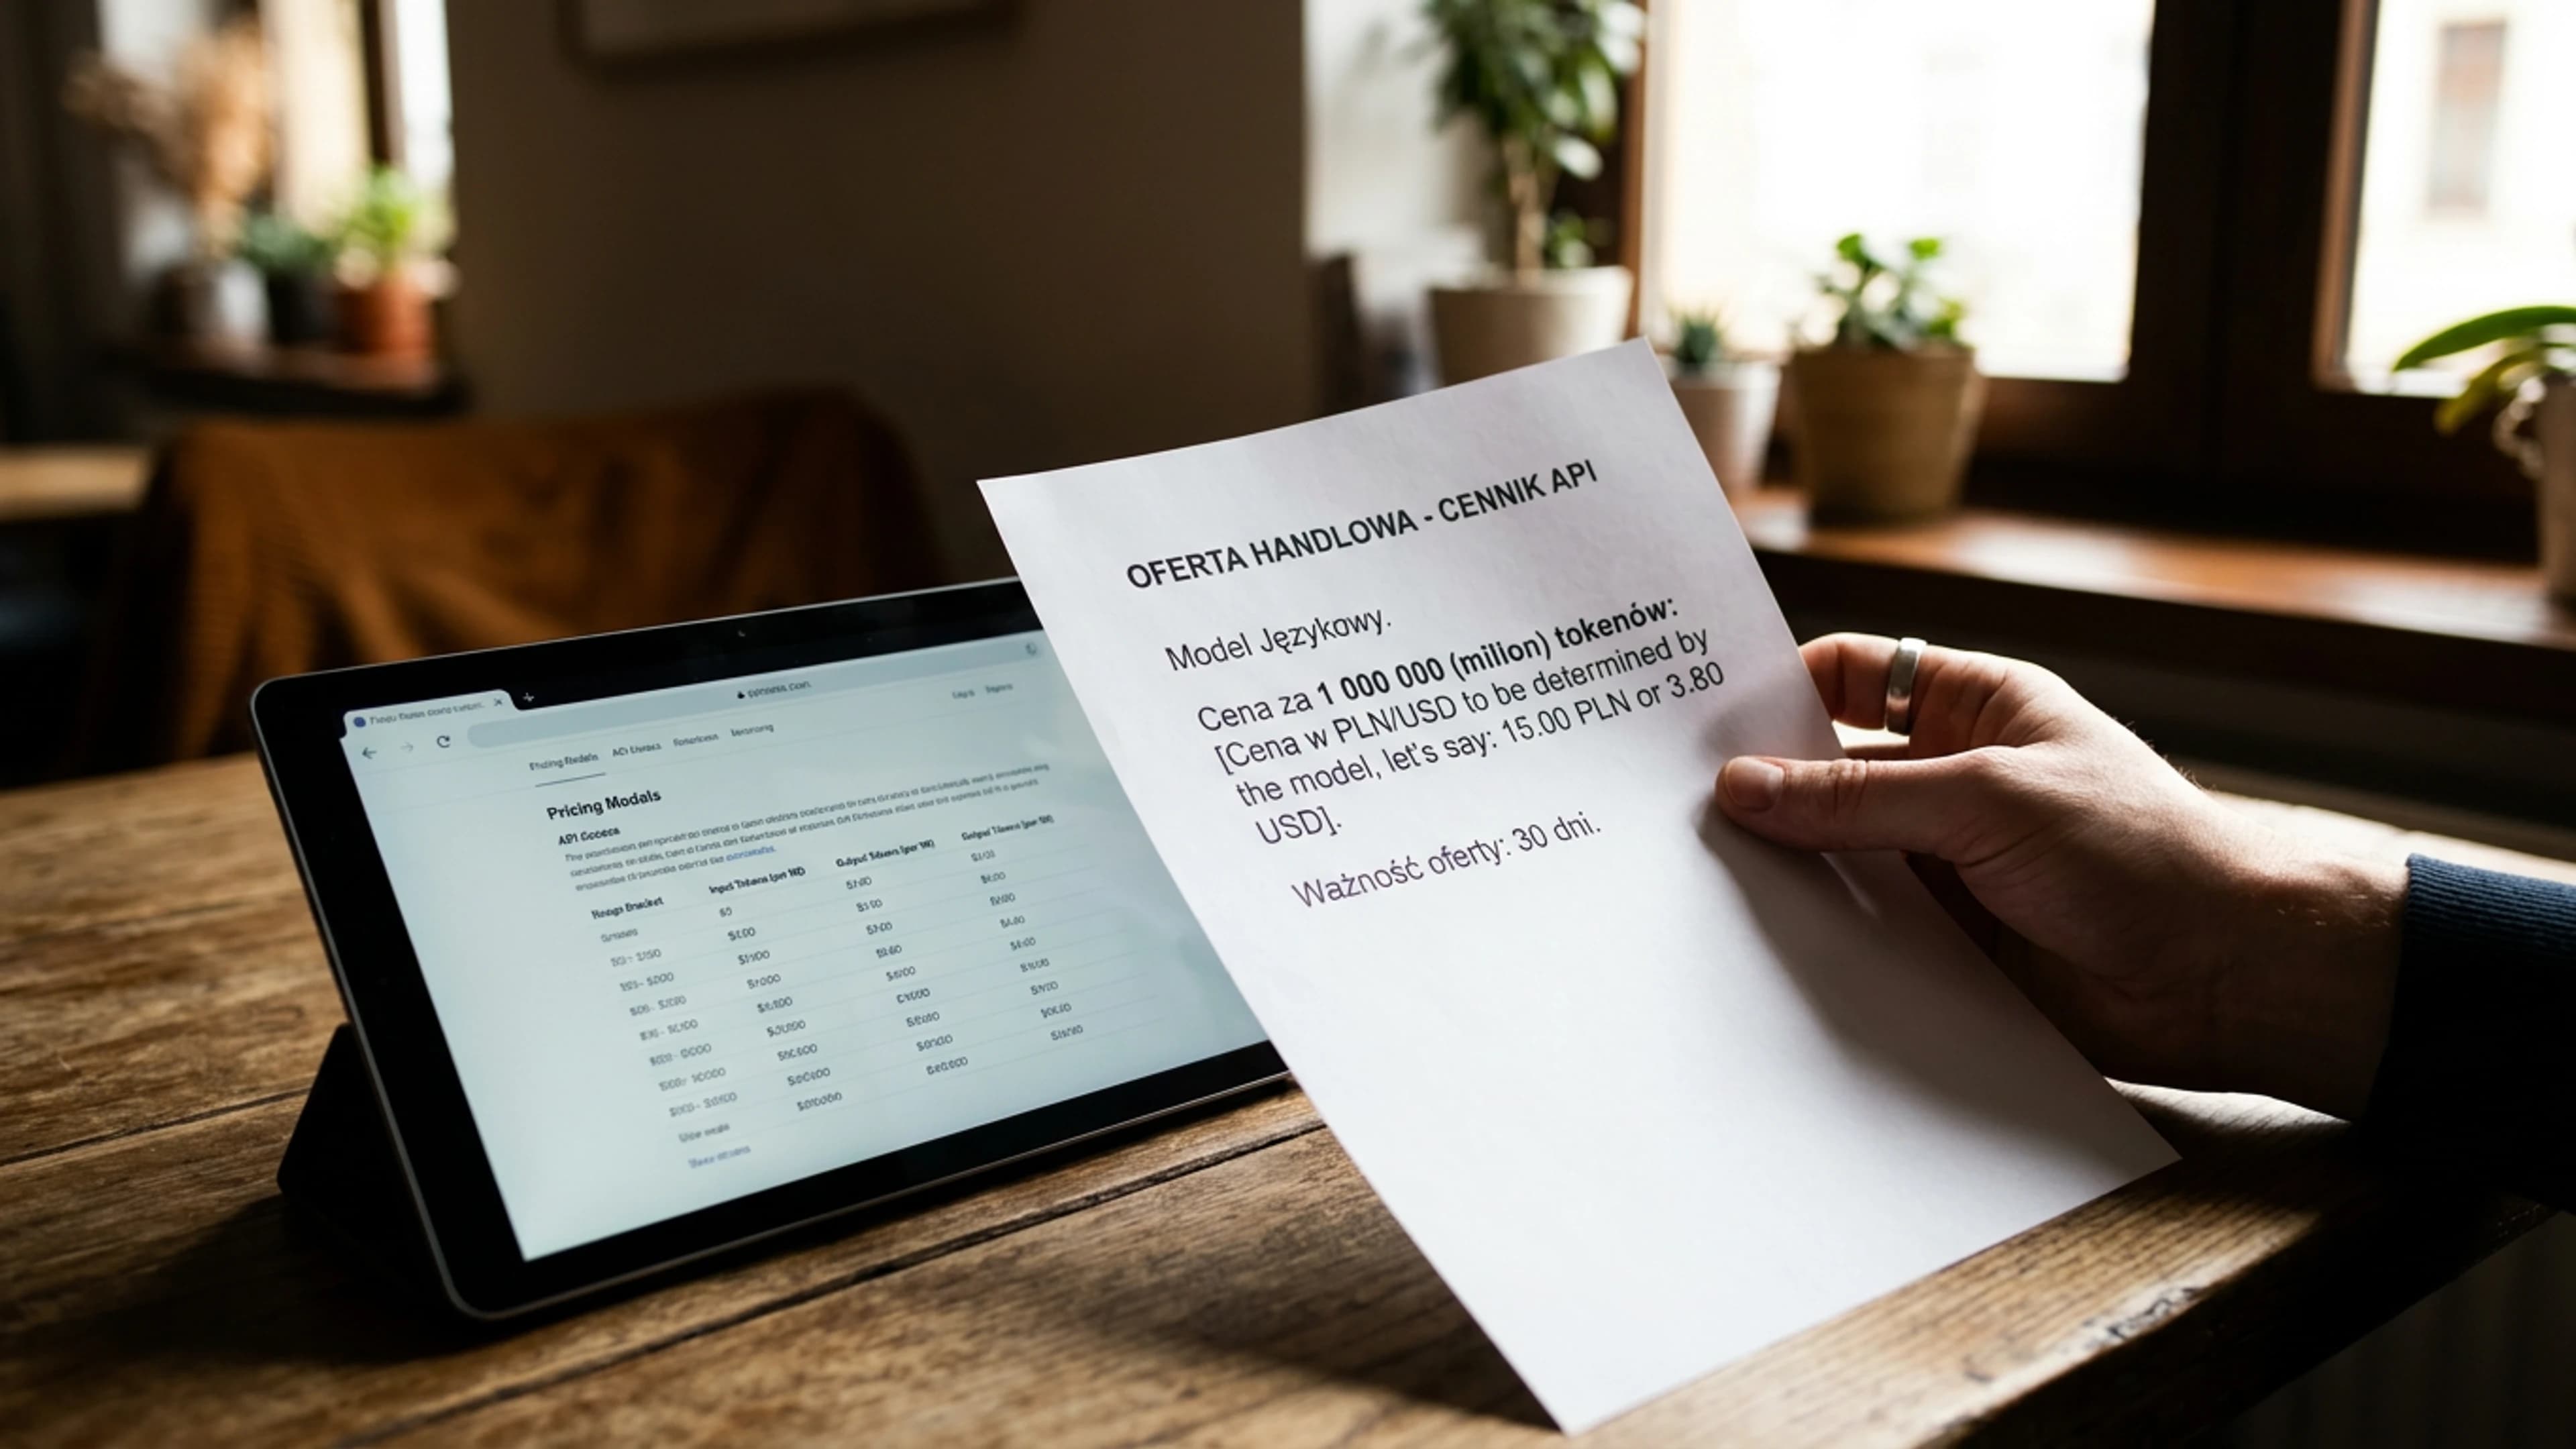
API modeli językowych jest tanie i łatwe do opakowania. Interfejs, prompt i warstwa RAG nad GPT-4o powstają w tydzień, a oficjalny cennik OpenAI podaje 2,50 USD za milion tokenów wejściowych dla modelu GPT-4o mini. Dostawca, który nie kontroluje modelu, nie może przejąć odpowiedzialności za błędy producenta ani zagwarantować regionu przetwarzania. W RODO art. 28 wymaga umowy powierzenia i listy podprocesorów — nakładka zwykle nie ma żadnej z tych rzeczy. Stąd biorą się oferty 10 razy droższe od cennika API bez uzasadnienia inżynierskiego.
Co z tym zrobić u siebie
Na spotkaniu z dostawcą warto przejść przez 12 pytań kontrolnych. Pierwsze: jaki dokładnie model bazowy, wersja i endpoint. Drugie: czy umowa jest bezpośrednio z producentem modelu lub przez Microsoft Azure, Google Cloud, AWS — i jaki jest status partnera. Trzecie: czy możliwe jest BYOK i rozliczanie bezpośrednie. Czwarte: kto jest podmiotem przetwarzającym RODO i jaka jest lista podprocesorów. Piąte: w jakim regionie przetwarzane są dane i czy dostępna jest opcja wyłącznie EU. Szóste: czy rozwiązanie to fine-tuning, RAG, wektoryzacja — czy tylko UI i prompt. Siódme: cena netto za 1 mln tokenów wejściowych i wyjściowych. Ósme: gwarantowane SLA i sposób ich mierzenia. Dziewiąte: czy można zmienić model bazowy bez zmiany umowy i czy zagwarantowano eksport danych. Dziesiąte: czy wykonano testy prompt injection i halucynacji oraz jak są raportowane. Jedenaste: jak dostawca klasyfikuje system wg AI Act i które obowiązki przyjmuje jako dostawca. Dwunaste: kto odpowiada za błędy modelu i jakie są limity odpowiedzialności.
Różnica między integracją a nakładką sprowadza się do kontroli i odpowiedzialności. Integracja to konfiguracja modelu w architekturze klienta z warstwą bezpieczeństwa, monitoringiem, SLA, umową powierzenia i odpowiedzialnością za całość. Nakładka to interfejs lub prompt nad cudzym API, bez kontroli nad modelem i bez odpowiedzialności za błędy producenta. W praktyce sprawdzamy to przez porównanie ceny za tokeny z oficjalnym cennikiem producenta. Mediana marży integratorskiej dla integracji wynosi 18–35% kosztu modelu. Oferta 10 razy wyższa od cennika API bez uzasadnienia inżynierskiego powinna zostać odrzucona.
Kiedy to NIE zadziała
Nakładka bywa dopuszczalna, gdy spełnia cztery warunki: jawne oznaczenie, że to interfejs na cudzym modelu, cena zbliżona do kosztu API plus marża 5–15%, opcja BYOK i krótki pilotaż przy niskim poziomie ryzyka. W branżach regulowanych — finanse, zdrowie, e-commerce — nakładka bez kontroli nad regionem przetwarzania zwykle nie przechodzi testu RODO. Ustawa o zwalczaniu nieuczciwej konkurencji obejmuje też wprowadzanie w błąd co do własnego modelu, więc dostawca, który ukrywa, że odsprzedaje cudze API, ryzykuje spór prawny. W praktyce granica 50% marży bez własnych komponentów to punkt, od którego warto poprosić o audyt techniczny.
HEXART pomaga przejść przez te 12 pytań w praktyce: sprawdzamy oferty, porównujemy ceny z cennikami producentów i przygotowujemy listę dowodów do audytu dostawcy. Więcej o naszych wdrożeniach na hexart.pl.
Materiały, do których zaglądaliśmy przy pisaniu. Tekst powyżej jest nasz; te strony nie odpowiadają za jego treść ani jej nie autoryzowały.